AI 토큰이란 무엇인가? 요금과 무료 한도가 빨리 차는 이유
AI 요금이나 무료 한도가 왜 이렇게 빨리 차는지 궁금하다면, 답은 '토큰(token)'이라는 단위에 있습니다.
토큰은 AI가 글을 처리하고 요금을 매길 때 쓰는 최소 단위이고, 대화가 길어질수록·한국어를 쓸수록 이 토큰이 더 빨리 쌓여 한도가 금방 찹니다.
이 글을 읽으면 토큰이 뭔지, 왜 한국어가 영어보다 손해인지, 무료 한도를 아껴 쓰는 법까지 한 번에 정리됩니다.
개발 지식이 없어도 괜찮습니다. 택시 미터기와 레고 조각, 이 두 가지 비유만 따라오면 됩니다.
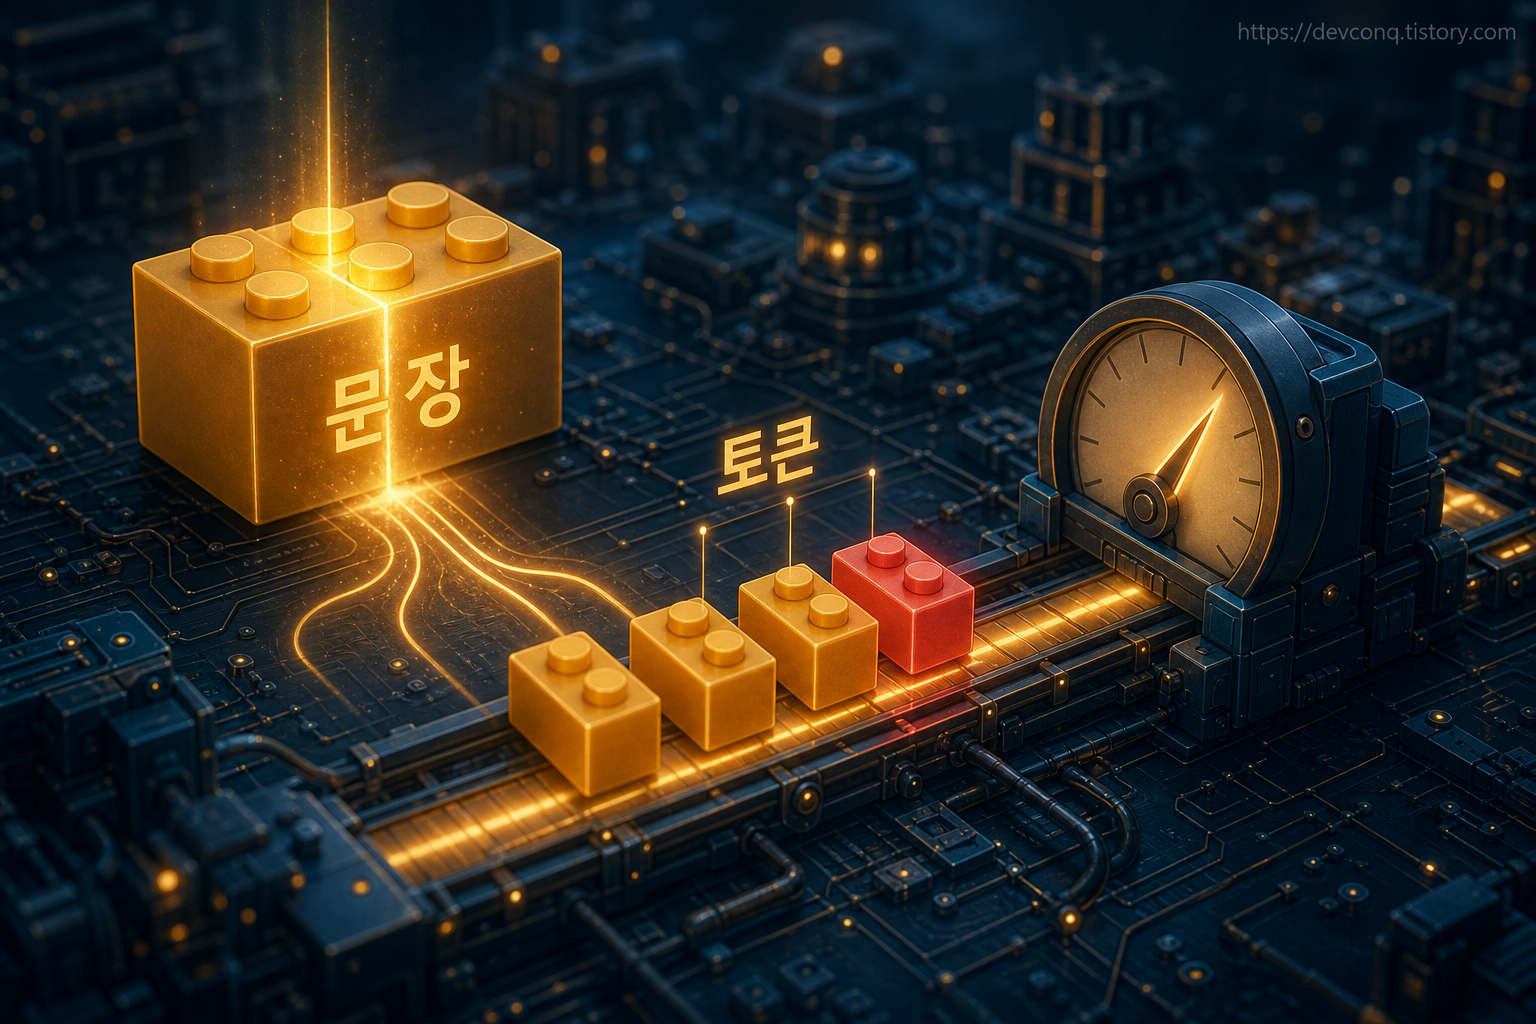
토큰은 AI가 텍스트를 잘라 처리하는 최소 조각입니다. 영어는 대략 4글자가 1토큰이고, 내 질문과 AI 답변이 모두 토큰으로 계산됩니다. 대화가 길어질수록 토큰이 눈덩이처럼 불어나 무료 한도가 빨리 찹니다.
토큰이란 무엇인가
토큰은 AI가 글을 이해하려고 잘게 쪼갠 조각입니다.
OpenAI 공식 설명에 따르면 토큰은 글자 하나만큼 짧을 수도, 단어 하나만큼 길 수도 있습니다.
레고를 떠올리면 쉽습니다.
AI는 문장을 통째로 삼키지 않고, 레고 블록처럼 작은 조각으로 분해한 뒤 처리합니다.
영어 기준으로는 대략 4글자가 1토큰, 100토큰이 약 75단어 정도입니다.
이렇게 쪼개는 방식을 BPE(Byte-Pair Encoding)라고 부릅니다.
자주 등장하는 글자 조합(예: "ing", "the")을 하나의 조각으로 묶어두는 방식입니다.
왜 무료 한도가 금방 찰까
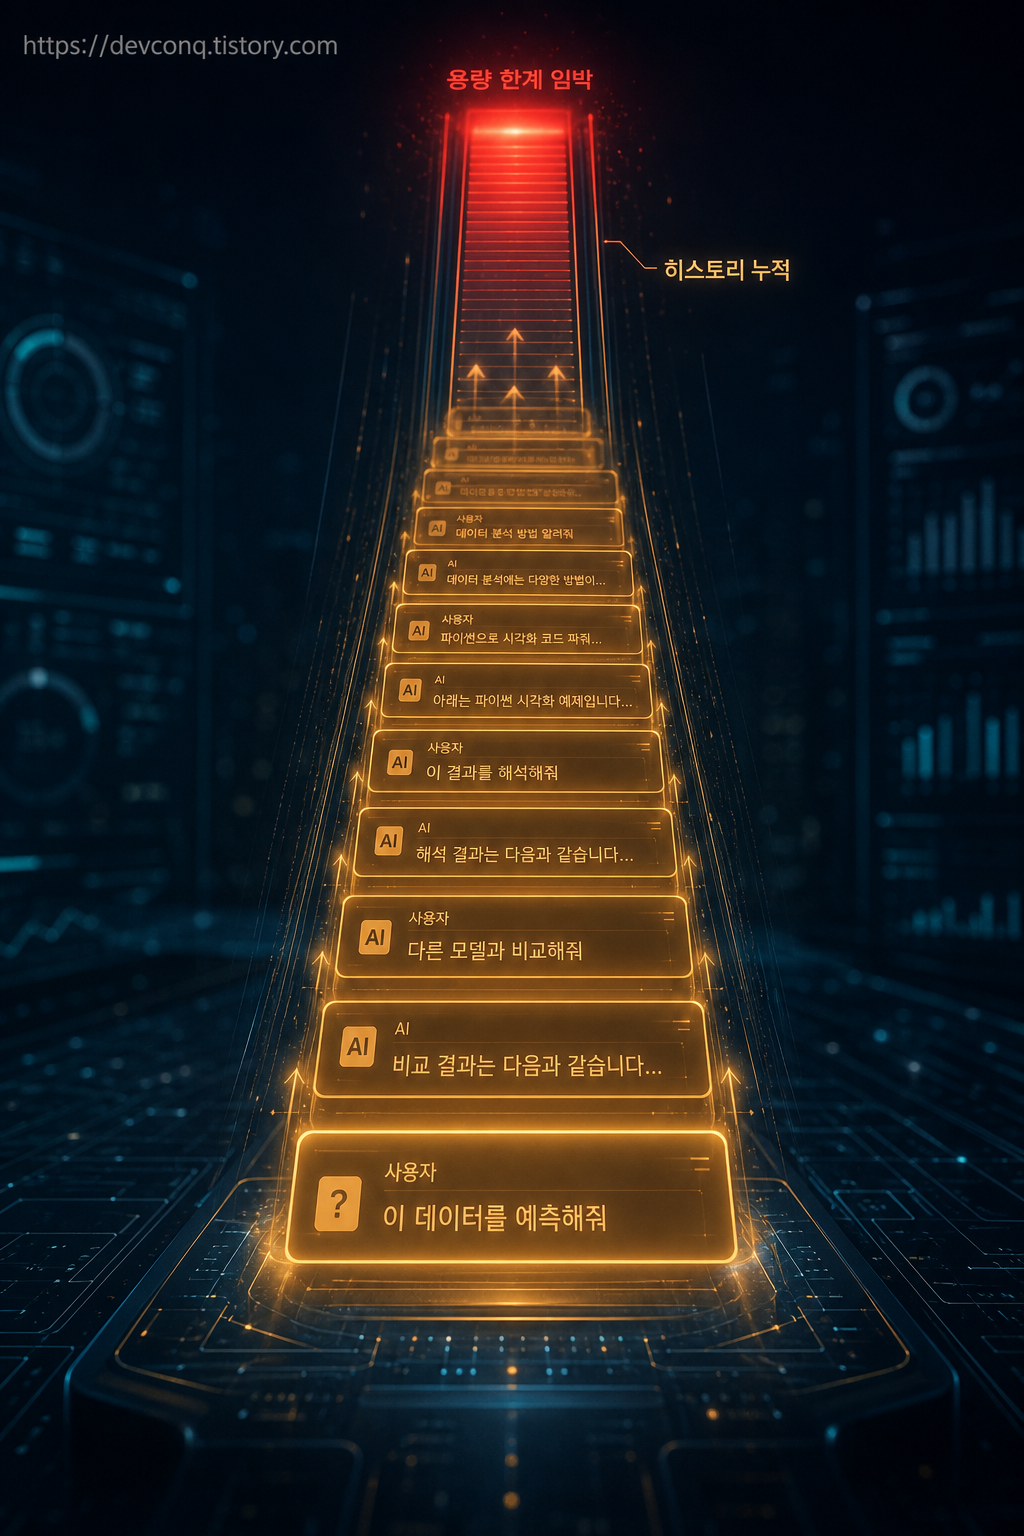
가장 큰 이유는 대화 히스토리가 매번 다시 계산되기 때문입니다.
AI는 앞 대화를 기억하려고, 새 질문을 할 때마다 지금까지의 대화 전체를 함께 다시 읽습니다.
여기서 택시 미터기 비유가 딱 맞습니다.
짧게 한마디 하면 미터가 조금 오르지만, 대화가 길어지면 질문 하나에 미터가 훌쩍 뛰어오릅니다.
그래서 초반 질문은 토큰을 적게 쓰지만, 뒤로 갈수록 똑같은 한 줄 질문이 수십 배의 토큰을 잡아먹습니다.
무료 플랜은 보통 3~5시간 단위로 메시지 수나 토큰 총량에 제한을 둡니다.
대화가 길수록 이 한도가 훨씬 빨리 소진되는 구조입니다.
주요 플랫폼의 무료 한도는 아래 표와 같습니다.
다만 이 수치는 자주 바뀌므로 참고용으로만 보고, 실제 사용 전 공식 문서를 확인하는 편이 안전합니다.
| 플랫폼 | 무료 한도 (2026년 7월 기준, 변동 잦음) |
|---|---|
| ChatGPT | 상위 모델은 5시간당 약 10메시지 뒤 가벼운 모델로 전환(롤링) |
| Claude | 5시간당 약 15~40메시지(가변, 공식 수치 비공개·서버 부하에 유동) |
| Gemini | 5시간마다 갱신 + 주간 상한, API 무료는 분당 15요청 |
위 수치는 제3자 집계와 공식 FAQ를 정리한 값입니다. 요금제와 한도는 시점·국가·계정에 따라 달라지므로 발행 전 공식 문서 확인이 필요합니다.
한국어는 왜 영어보다 빨리 닳을까
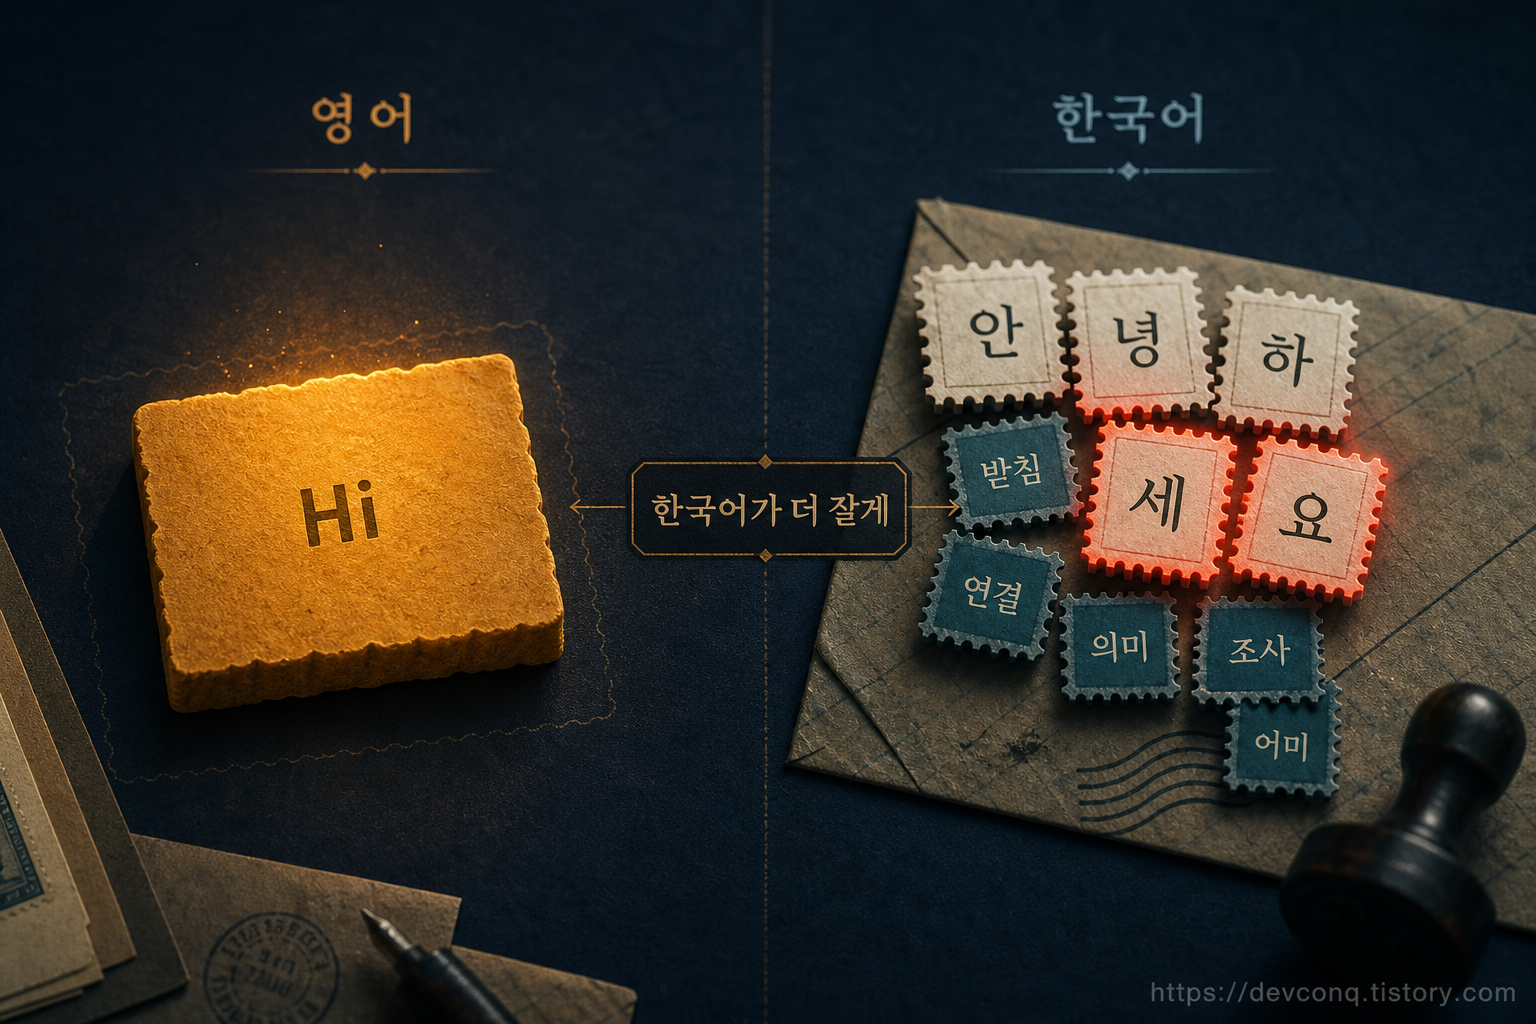
같은 내용을 물어봐도 한국어가 영어보다 토큰을 더 많이 씁니다.
토큰을 쪼개는 방식이 영어 데이터를 중심으로 학습됐기 때문입니다.
영어의 흔한 단어 조합은 통째로 1토큰이 되지만, 한국어는 음절 단위로 잘게 쪼개지는 경우가 많습니다.
영어 "hello"는 1토큰이지만, "안녕하세요"는 모델에 따라 3~5토큰으로 쪼개지는 식입니다.
한국어는 어미 변형도 많습니다("먹다 / 먹었다 / 먹었었겠다").
삼성SDS는 과거 측정치에서 한국어가 영어의 약 4~5배 토큰을 쓴다고 봤고, KITPA는 3~5배로 집계했습니다.
반면 개인 실험에서는 1.4배 수준으로 나온 사례도 있습니다.
정리하면, 모델·버전에 따라 다르지만 한국어는 영어보다 대략 1.5~5배의 토큰을 쓴다는 것이 여러 실험의 공통된 흐름입니다.
정확한 배수는 모델마다 다르므로 발행 전 재확인이 필요합니다.
개인적으로는 이 점이 한국 사용자가 무료 한도를 유독 빨리 소진한다고 느끼는 진짜 이유라고 봅니다.
컨텍스트 윈도우는 또 뭔가
컨텍스트 윈도우는 AI가 한 번에 기억하고 처리할 수 있는 최대 토큰 수입니다.
이 한도를 넘으면 오래된 대화부터 잘려나가서, AI가 앞 내용을 잊어버립니다.
2026년 기준 최신 상위 모델은 약 100만(1M) 토큰까지 다룹니다.
다만 창이 크다고 무조건 좋은 건 아닙니다.
대화가 길어질수록 응답이 느려지고, 중간에 있는 정보를 덜 정확하게 다루는 현상도 생깁니다.
그래서 실전에서는 최대치의 60~80% 정도까지만 채워 쓰는 편이 안정적입니다.
토큰을 아끼는 현실적인 방법
토큰을 아끼면 무료 한도도 오래가고 응답도 빨라집니다.
가장 쉬운 방법부터 정리하면 다음과 같습니다.
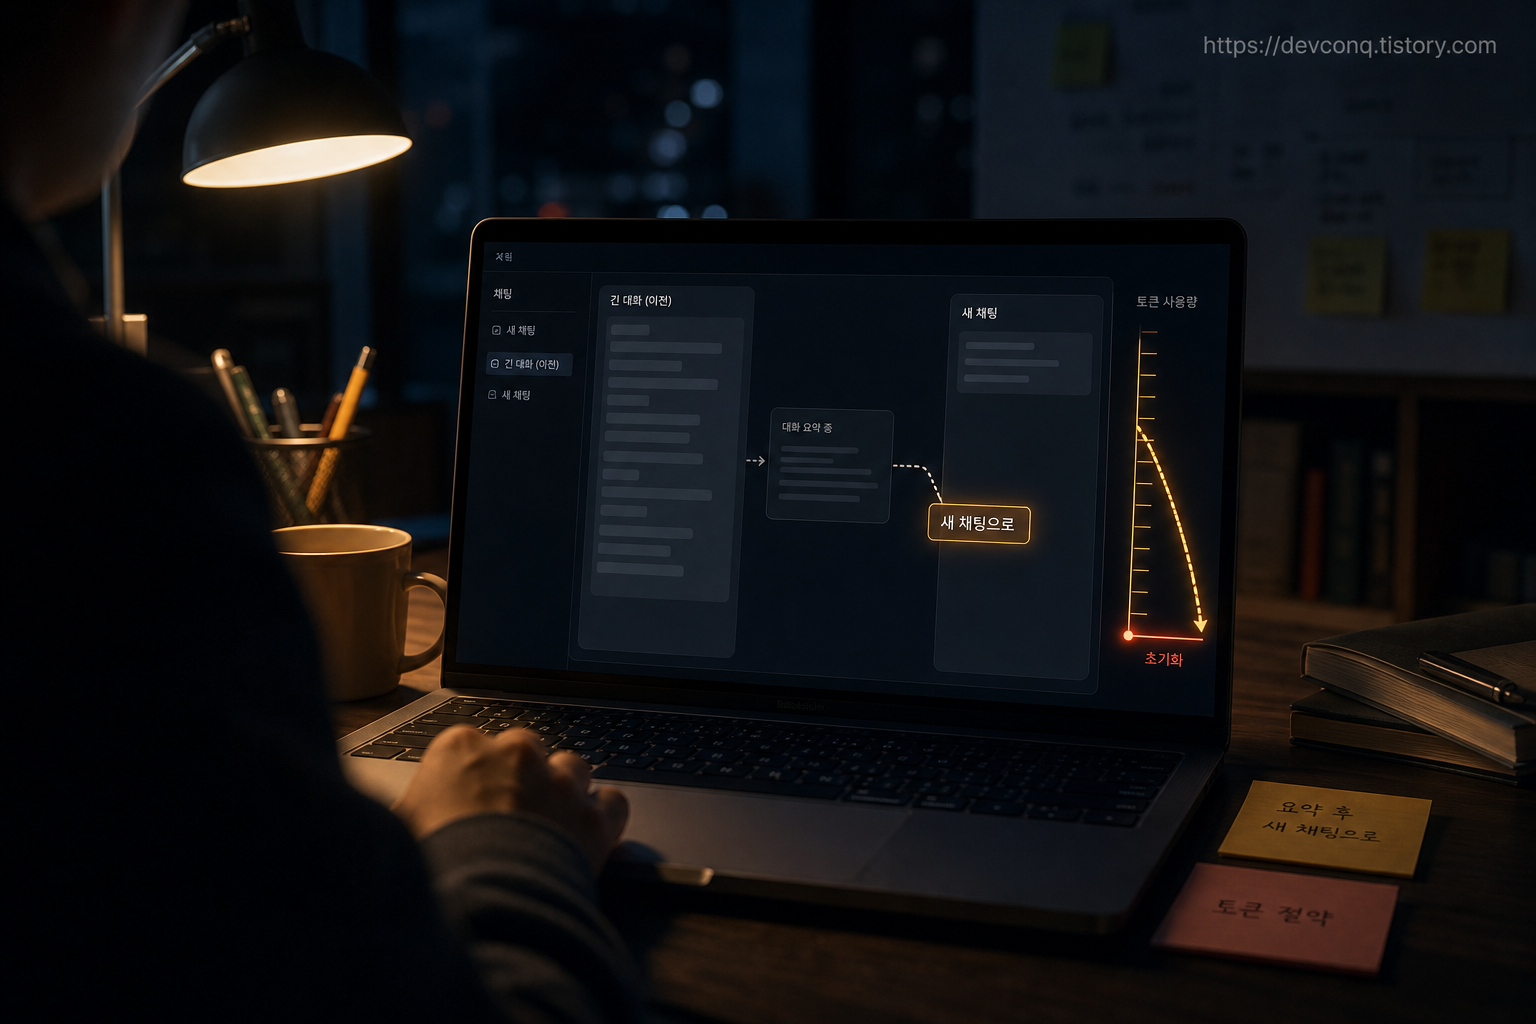
✅ 대화가 15~20개 넘어가면 핵심만 요약해 새 채팅으로 옮기기
✅ "3번 섹션만 다시" 같이 짧고 구체적으로 요청하기
✅ 긴 문서는 통째로 붙이지 말고 필요한 부분만 넣기
✅ "다시 해줘"보다 원래 메시지를 수정해 다시 보내기
이 중 하나만 지켜도 무료 한도가 눈에 띄게 오래 버팁니다.
자주 묻는 질문
토큰이 정확히 뭔가요?
토큰은 AI가 텍스트를 쪼개 처리하는 최소 단위입니다.
영어는 대략 4글자가 1토큰이고, 내 질문과 AI의 답변이 모두 토큰으로 계산됩니다.
왜 대화가 길어지면 한도가 금방 차나요?
AI가 앞 대화를 기억하려고 매 질문마다 대화 전체를 다시 토큰으로 계산하기 때문입니다.
그래서 뒤로 갈수록 같은 질문 하나가 초반보다 훨씬 많은 토큰을 씁니다.
제일 쉬운 절약법은 뭔가요?
대화가 15~20개를 넘으면 새 채팅을 시작하는 것입니다.
이전 대화의 핵심만 짧게 요약해 옮기면 토큰 낭비를 크게 줄일 수 있습니다.
결론
토큰은 결국 AI를 쓰는 데 드는 '요금 미터기'입니다.
대화가 길수록, 한국어를 쓸수록 미터가 더 빨리 오른다는 것만 이해하면 됩니다.
그래서 요금제를 고를 때도 "메시지 무제한"이라는 문구보다, 어떤 모델을 얼마나 쓸 수 있는지를 보는 편이 정확합니다.
무료 한도가 자주 차거나 긴 문서를 자주 다룬다면, 그때가 유료 전환을 고민할 시점입니다.