고정 헤더 영역

상세 컨텐츠
본문
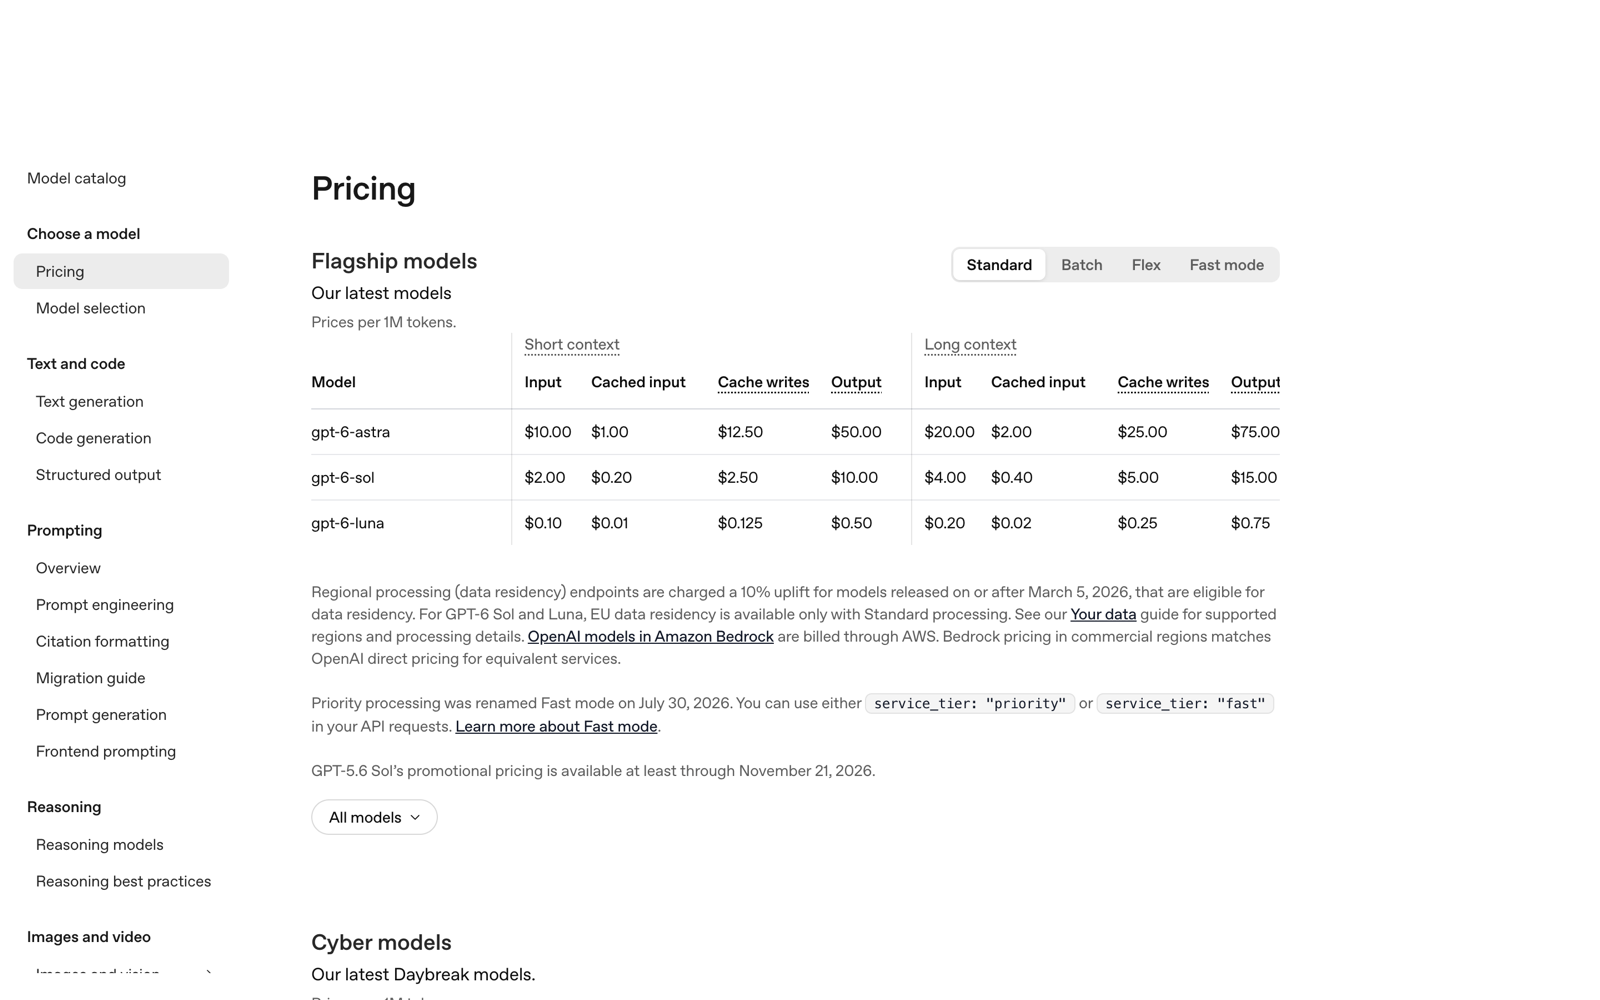
9월 22일, 앤트로픽과 오픈AI가 90분 간격으로 신모델을 내놨습니다. 그럼 지금은 GPT-6와 클로드 중 무엇을 써야 할까요?
답은 "무엇을 맡기느냐"에 따라 갈립니다. 대량 작업과 가성비는 GPT-6 솔·루나, 긴 코딩과 보고서 품질은 클로드 오퍼스 5.5, 가장 어려운 컴퓨터 조작과 과학 연구는 GPT-6 아스트라가 유리합니다.
가격표, 성능표, 구독 요금제를 한자리에 놓고, 두 회사 발표문이 서로 다르게 말하는 부분까지 대조했습니다.
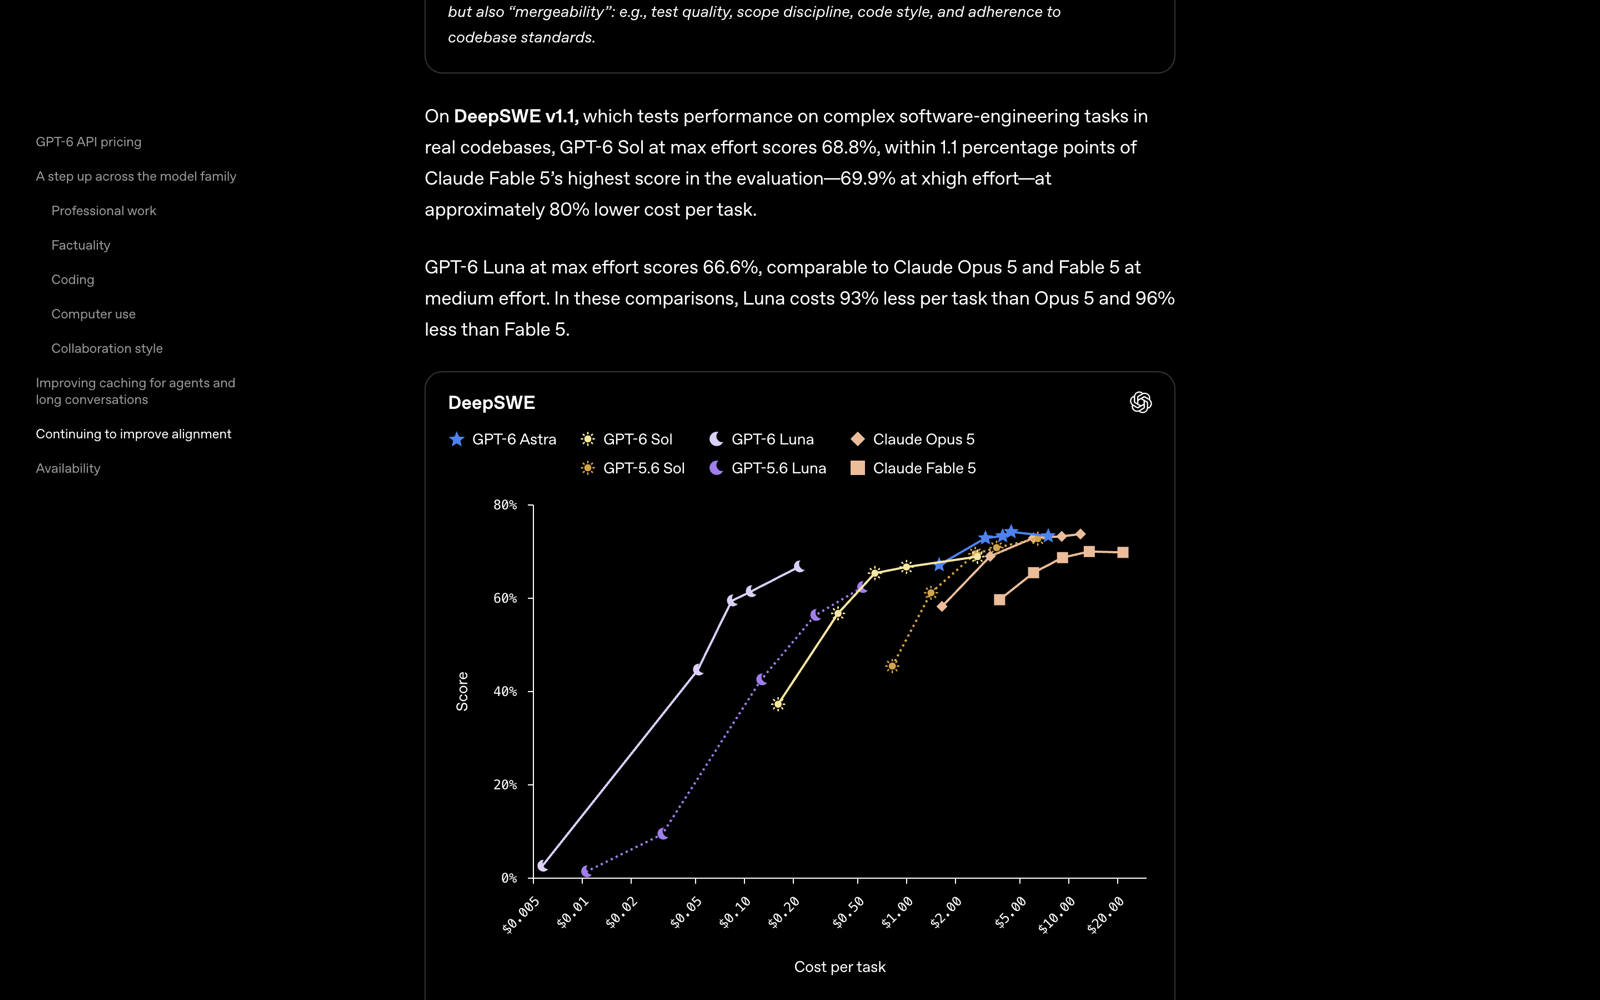
가격만 보면 GPT-6 솔(입력 2달러·출력 10달러)이 클로드 오퍼스 5.5(4달러·20달러)의 절반이다. 하지만 앤트로픽 발표 기준 오퍼스 5.5는 코딩·전문 업무 평가에서 아스트라보다 높은 점수를 더 낮은 작업당 비용으로 냈다. 토큰 단가와 실제 작업 비용은 다르게 봐야 한다.
두 회사 모델은 1대1로 맞지 않는다
비교를 어렵게 만드는 첫 번째 이유는 등급이 서로 어긋난다는 점입니다.
최상위끼리는 가격이 같습니다. 그런데 한 칸 내려가면 클로드에는 오퍼스 5.5가, GPT-6에는 솔이 있고, 둘의 가격은 두 배 차이가 납니다.
| 등급 | GPT-6(오픈AI) | 클로드(앤트로픽) |
|---|---|---|
| 최상위 | 아스트라 10달러 / 50달러 | 페이블 5.1 10달러 / 50달러 |
| 고성능 주력 | 대응 모델 없음 | 오퍼스 5.5 4달러 / 20달러 |
| 균형형 | 솔 2달러 / 10달러 | 소네트 5 2달러 / 10달러 |
| 경량 | 루나 0.10달러 / 0.50달러 | 하이쿠 4.5 1달러 / 5달러 |
| 캐시 읽기(주력 기준) | 솔 0.20달러, 루나 0.01달러 | 오퍼스 5.5 0.20달러, 소네트 5 0.20달러 |
가격은 각 사 공식 API 가격표 기준이며, 모두 100만 토큰당 입력 / 출력 요금입니다.
입력은 내가 보내는 글, 출력은 AI가 써 주는 글의 분량입니다. 두 회사 모두 출력 단가가 입력의 5배입니다.
눈에 띄는 건 두 가지입니다. 솔은 소네트 5와 가격이 정확히 같고, 루나는 하이쿠 4.5보다 입력·출력 모두 10분의 1 가격입니다.
오퍼스 5.5는 그 사이 어디에도 없는 자리를 잡았습니다. 솔보다 두 배 비싸고, 아스트라·페이블보다는 절반 이하입니다.
오퍼스 5.5의 경쟁 상대는 가격상 솔이 아니라, "아스트라를 쓸까 말까" 고민하던 작업이다.
같은 시험인데 점수가 다르다
두 번째 이유는 벤치마크입니다. 각 회사 발표문의 표를 나란히 놓으면 이상한 점이 보입니다.
저는 컴퓨터 조작 능력을 재는 OSWorld 2.0에서 멈췄습니다. 같은 클로드 오퍼스 5의 점수가 두 발표문에서 다르게 적혀 있었거든요.
| 평가 항목 | 앤트로픽 발표문 | 오픈AI 발표문 |
|---|---|---|
| OSWorld 2.0, Claude Opus 5 | 74.0%(부분 점수) | 70.2% |
| Terminal-Bench 4.0, GPT-6 Astra | 57.9%(오픈AI 보고 수치 인용) | 57.9% |
| AutomationBench 비교 상대 | 오퍼스 5.5 40.0% vs 아스트라 41.4% | 솔(xhigh) 33.2% vs 오퍼스 5(max) 26.9% |
오픈AI는 각주에서 클로드 점수를 공식 리더보드 설정으로 다시 잰 값이라고 밝혔습니다. 앤트로픽은 자체 설정으로 쟀고요. 측정 조건이 다르면 같은 모델도 점수가 바뀝니다.
비교 상대를 고르는 방식도 다릅니다. 같은 날 나온 탓에 오픈AI 솔 발표문은 오퍼스 5와, 앤트로픽 발표문은 GPT-5.6 솔·아스트라와 비교했습니다.
즉 GPT-6 솔과 오퍼스 5.5를 직접 맞붙인 공식 수치는 아직 없습니다.
벤치마크 표는 "누가 더 똑똑한가"의 답이 아니라 "각 회사가 무엇을 보여 주고 싶은가"의 기록에 가깝다.
순위보다 각주다.
개인적으로는 이런 시기일수록 표의 순위보다 측정 조건을 먼저 읽는 습관이 필요하다고 봅니다.
그래도 확인되는 강점은 있다
조건 차이를 감안해도 양쪽 자료에서 일관되게 보이는 흐름이 있습니다.
클로드 오퍼스 5.5가 앞서는 쪽
- 터미널 코딩: Terminal-Bench 4.0에서 66.4%로 아스트라(57.9%)보다 높다. 앤트로픽은 기본 설정 기준 아스트라와 비슷한 점수를 약 40% 비용으로 냈다고 밝혔다.
- 전문 업무 문서: 44개 직업의 실무를 보는 GDPval-AA에서 1846점으로 아스트라(1542)를 크게 앞선다.
- 긴 작업의 정확성: 지어낸 숫자가 하나라도 있으면 탈락하는 보고서 시험에서 18번 중 16번 통과했다.
GPT-6가 앞서는 쪽
- 최상위 성능: 업무 자동화(AutomationBench 41.4%)와 과학 연구 과제(64.6%)는 아스트라가 오퍼스 5.5보다 높다.
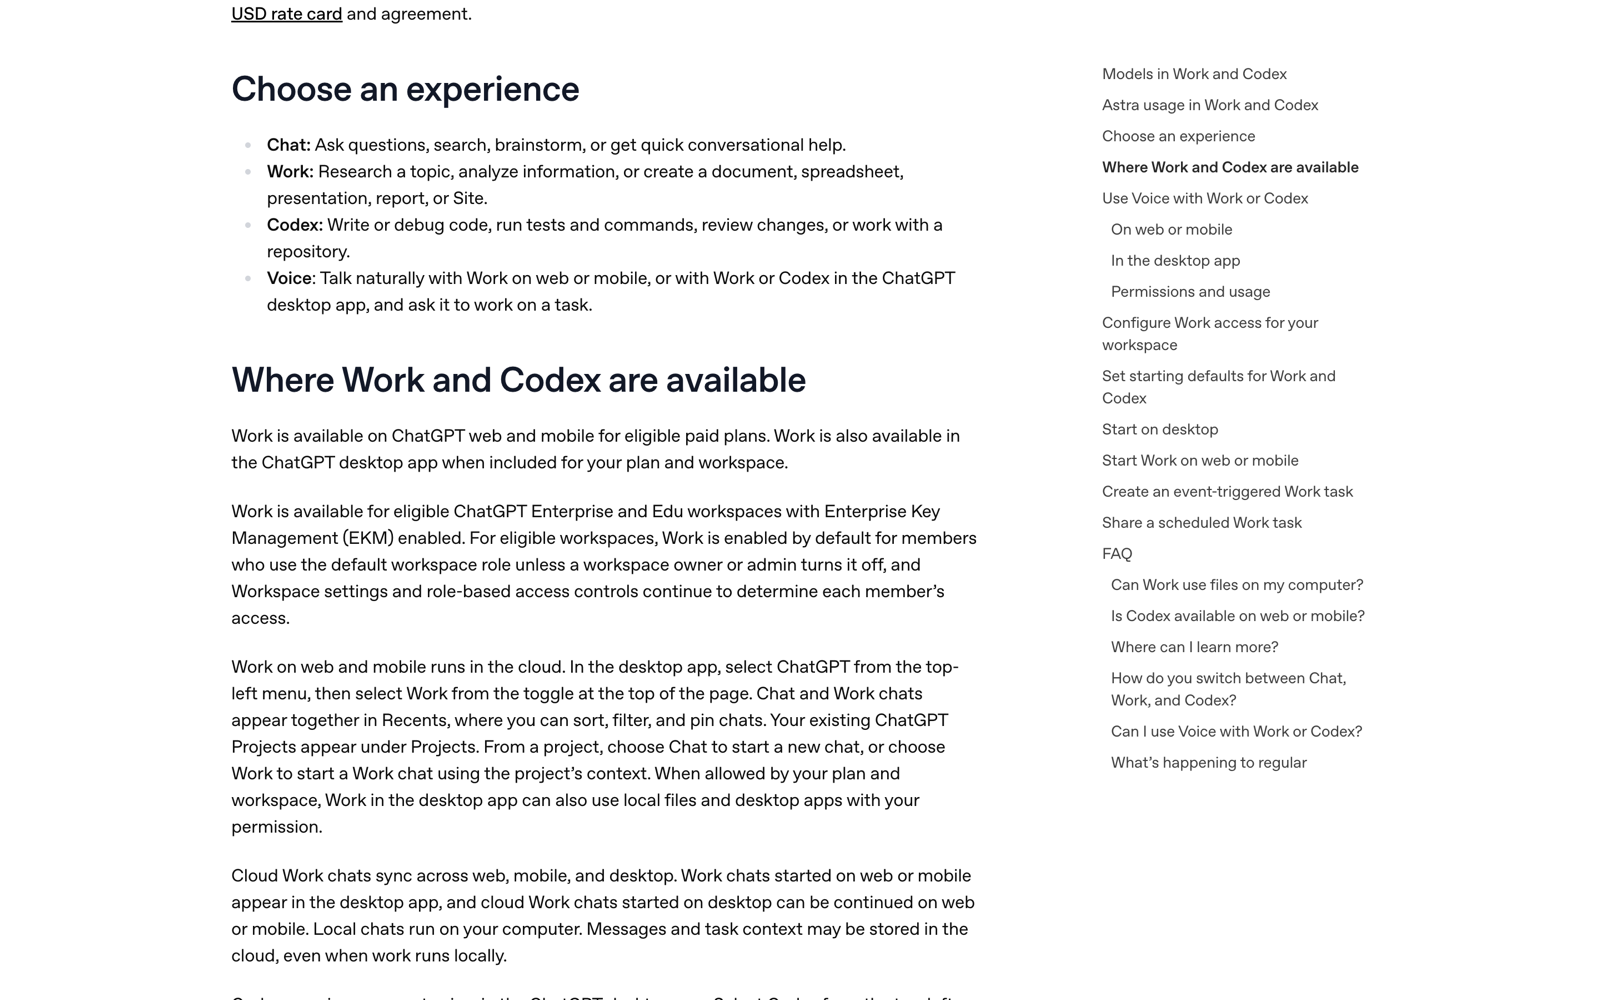
- 가성비: 솔은 컴퓨터 조작 평가에서 오퍼스 5와 비슷한 점수를 작업당 비용 약 80% 낮게 냈다. 루나는 코딩 평가에서 오퍼스 5 중간 설정과 비슷한 점수를 93% 낮은 비용으로 냈다.
- 초저가 대량 처리: 독립 평가기관 아티피셜 애널리시스 기준 루나의 작업당 비용은 평가 모델 중 두 번째로 낮았다(뉴스1 보도).
여기서 짚을 점은 "작업당 비용"이라는 말입니다. 토큰 단가가 싸도 한 번에 끝내지 못하고 여러 번 고치면 총비용은 오히려 커집니다.
오퍼스 5.5가 단가는 솔의 두 배인데도 비용 효율을 내세우는 이유가 여기 있습니다. 적은 토큰으로 한 번에 끝낸다는 주장이죠.
정리하면 품질을 끝까지 밀어붙이는 긴 작업은 클로드 쪽, 같은 일을 많이 싸게 돌리는 작업은 GPT-6 쪽으로 기웁니다.
반응형
구독으로 쓴다면 요금제가 더 중요하다
API가 아니라 앱으로 쓰는 분에게는 모델보다 요금제가 먼저입니다.
| 구분 | 챗GPT | 클로드 |
|---|---|---|
| 무료 | 데스크톱 앱에서 GPT-6 루나 | 무료 요금제(고를 수 있는 모델 제한) |
| 월 20달러 | Plus: Work·Codex에서 솔·루나, 아스트라는 제한된 사용량 | Pro: 더 많은 모델, 클로드 코드 포함(연간 결제 시 월 17달러) |
| 월 100달러부터 | Pro 100달러: 아스트라 기반 GPT-6 Pro, 사용량 5배 | Max: Pro 대비 사용량 5배 또는 20배 |
| 최근 변화 | 9월 10일부터 Pro 200달러 신규 가입·업그레이드 일시 중단 | 오퍼스 5.5와 함께 5시간 사용 한도 상향, 저장형 사용량 리셋 제공 |
가격은 오픈AI 도움말 센터와 앤트로픽 요금 페이지 기준 미국 달러 요금입니다. 국내 결제 금액은 세금과 환율에 따라 다릅니다.
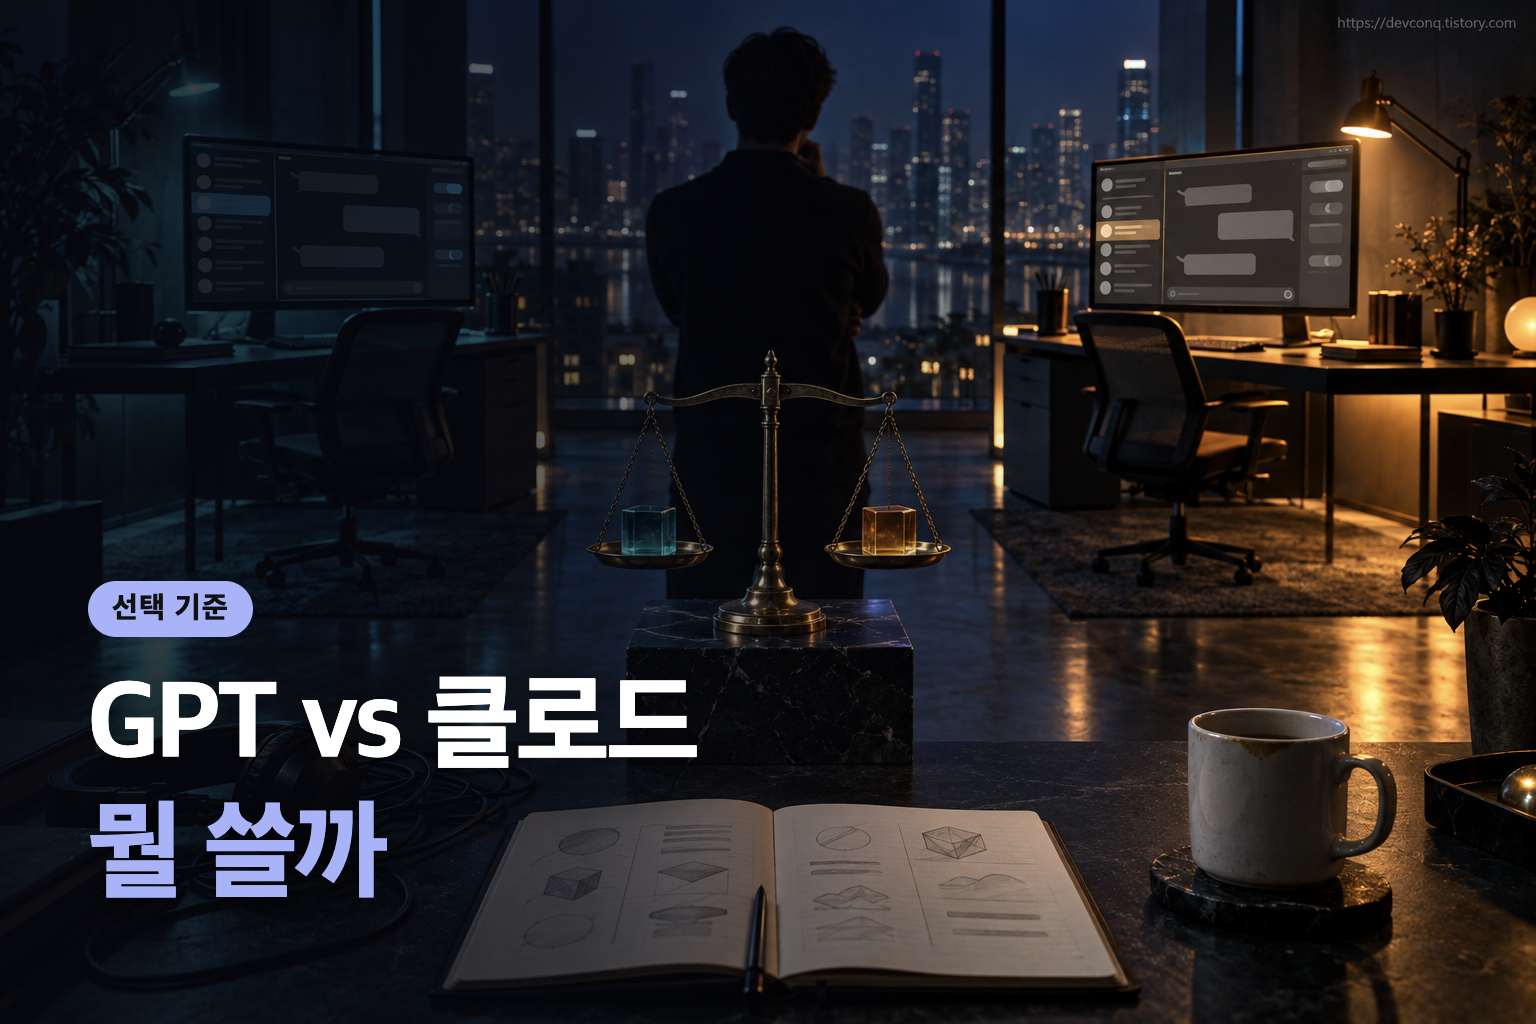
챗GPT에서는 쓰는 "방"도 신경 써야 합니다. GPT-6 솔과 루나는 일반 대화(Chat)가 아니라 Work와 Codex에서만 고를 수 있습니다.
일반 대화창에서 아스트라급 모델을 쓰려면 Pro 100달러 이상이 필요하다는 점도 기억해 둘 만합니다. 도움말 센터 기준 아스트라 기반 GPT-6 Pro는 Pro와 Business·Enterprise 요금제에 열려 있습니다.
클로드 쪽은 월 20달러 Pro부터 클로드 코드가 들어 있어, 코딩 도구까지 한 구독으로 묶고 싶은 분에게 계산이 단순합니다.
안전장치는 양쪽 다 조였다
두 회사 모두 이번 모델의 정렬 평가 결과가 역대 최고라고 밝혔습니다. 정렬은 AI가 사람이 정한 범위와 의도대로 움직이는 정도를 말합니다.
동시에 보안 작업에는 선을 그었습니다. 아스트라는 오픈AI 모델 중 처음으로 사이버 보안 Critical 등급을 받아 고급 보안 기능 접근이 따로 제한됩니다.
오퍼스 5.5도 일상적인 버그 수정은 돕지만, 보안 공격·방어 성격의 요청은 대부분 이전 세대 모델로 자동 전환됩니다.
일반 사용자에게는 거의 영향이 없고, 보안 업무를 하는 분이라면 양쪽 모두 별도 검증 프로그램을 거쳐야 한다는 점만 기억하면 됩니다.
상황별로 고르면 이렇다
| 이런 일을 맡긴다면 | 먼저 써 볼 모델 | 이유 |
|---|---|---|
| 문서 수백 개 요약·분류, 데이터 추출 | GPT-6 루나 | 토큰 단가가 압도적으로 낮음 |
| 매일 하는 코딩·리뷰, 적당한 난도 | GPT-6 솔 또는 클로드 소네트 5 | 가격이 같으니 익숙한 쪽을 쓰면 된다 |
| 몇 시간 걸리는 코드 이전·대형 리팩터링 | 클로드 오퍼스 5.5 | 긴 작업 사례와 코딩 평가에서 강점 |
| 숫자 하나 틀리면 안 되는 보고서 | 클로드 오퍼스 5.5 | 지어낸 수치 없이 통과한 비율이 높음 |
| 여러 앱을 오가는 업무 자동화, 과학 분석 | GPT-6 아스트라 | 해당 평가에서 최고점 |
| 무료로 최신 모델 맛보기 | 챗GPT 데스크톱 앱의 루나 | 무료 계정에 열린 GPT-6 |
두 서비스를 모두 쓸 수 있다면, 같은 과제를 한 번씩 돌려 보고 재작업 횟수를 세는 게 가장 정확한 비교입니다.
자주 묻는 질문
Q. GPT-6와 클로드 중 코딩에는 뭐가 더 좋나요?
A. 긴 작업과 대형 리팩터링은 클로드 오퍼스 5.5가 공식 평가에서 앞섭니다. 짧고 반복적인 코딩을 싸게 돌리려면 GPT-6 솔이나 루나가 비용 면에서 유리합니다.
Q. 가장 싼 선택지는 무엇인가요?
A. API 기준으로는 GPT-6 루나입니다. 100만 토큰당 입력 0.10달러, 출력 0.50달러로 클로드 하이쿠 4.5의 10분의 1 수준입니다.
Q. 벤치마크 점수는 믿어도 되나요?
A. 참고는 되지만 그대로 믿기는 어렵습니다. 같은 오퍼스 5도 회사마다 측정 설정이 달라 점수가 4%포인트 가까이 차이 났습니다. 순위보다 각주의 측정 조건을 먼저 보세요.
결국 하나를 고른다면
저라면 매일 쓰는 도구는 이미 익숙한 쪽을 유지하겠습니다. 솔과 소네트 5가 같은 가격대라 갈아탈 이유가 크지 않습니다.
대신 몇 시간짜리 코딩이나 틀리면 곤란한 보고서가 생기면 오퍼스 5.5를, 수백 건짜리 반복 작업이 생기면 루나를 꺼내겠습니다. 이번 발표의 교훈은 한 모델에 모든 일을 맡기는 시대가 끝났다는 것입니다.
728x90
'AI 이야기 > 요즘 소식' 카테고리의 다른 글
| GPT-5.5, 10월 14일 챗GPT에서 빠진다 | API는 그대로, 코덱스 사용자가 바꿀 설정 (0) | 2026.09.27 |
|---|---|
| 맞춤 GPT 12월 11일 종료 | GPTs 공유가 막힌 이유와 기존 GPT 옮기는 법 (0) | 2026.09.25 |
| 클로드 오퍼스 5.5 출시 | 오퍼스 5보다 40% 싸진 이유와 구독자 혜택 (0) | 2026.09.24 |
| GPT-6 아스트라·솔·루나 차이 총정리 | 가격·성능과 챗GPT 어디서 쓰나 (0) | 2026.09.24 |
| AI 영화는 누가 만드나? 유토파이 스튜디오(Utopai Studios)와 PAI 2.0 (0) | 2026.09.23 |


댓글 영역