고정 헤더 영역

상세 컨텐츠
본문
728x90
반응형
챗GPT에게 "이 문의 급한 거야?"라고 물으면 친절한 문단이 돌아옵니다. 그런데 프로그램이 필요한 건 문단이 아니라 예·아니오 하나와 그 확신 정도입니다.
9월 15일 공개된 Jev는 바로 그 틈을 노린 AI 모델입니다. 문장을 쓰지 않고, 미리 정해 둔 형식의 판정값만 돌려줍니다.
이 글은 Jev가 무엇인지부터 플레이그라운드 사용법, API·SDK 호출, 결과 숫자 읽는 법, 실제로 써먹을 활용 패턴과 맡기면 안 되는 일까지 한 번에 정리합니다.
Jev는 TypeSafe AI가 만든 판정 전용 모델이다. 텍스트(상태)와 타입을 정한 질문을 보내면 예·아니오 확률, 보기 선택, 단계 점수를 확률·신뢰도와 함께 돌려준다. 공식 가격은 입력 100만 토큰당 0.042달러이고 출력은 무료다.
PART 01
Jev는 어떤 AI인가
한 줄 정의: 계산해 주는 if 문
Jev는 TypeSafe AI가 "System One 모델"이라고 부르는 새 계열의 첫 공개 모델입니다. 이름은 대니얼 카너먼의 『생각에 관한 생각』에서 빠르고 직관적인 사고를 뜻하는 시스템 1에서 따왔다고 합니다.
공식 문서의 설명을 줄이면 이렇습니다. 상태(state)와 타입을 정한 질문(questions)을 보내면, 모델이 각 질문을 동시에 평가해 코드가 바로 쓸 수 있는 값을 돌려줍니다. 문장 생성도, 답을 파싱하는 과정도 없습니다.
제가 가장 와닿게 이해한 비유는 "사람이 규칙으로 짜기 애매한 if 문 하나를 대신 계산해 주는 함수"입니다. "이 댓글이 광고인가", "이 문의는 어느 팀 일인가" 같은 판단을 정규식 대신 모델에 맡기고, 그 뒤의 분기는 평소처럼 코드가 처리합니다.
창업자 디오고 알메이다는 오픈AI에서 ChatGPT의 바탕이 된 지시 따르기 연구에 참여했다고 소개합니다. 공개 발표문에서 그는 Jev를 "프런티어급 지능을 가진 함수 호출"이라고 표현했습니다.
챗봇(LLM)과 무엇이 다른가
가장 큰 차이는 출력 방식입니다. 일반 LLM은 글자를 한 토큰씩 이어 붙여 답을 만들고, 우리는 그 문자열을 다시 파싱해야 합니다. Jev는 가능한 답의 형태를 요청할 때 정해 두고, 모든 질문의 답을 한 번에 병렬로 계산합니다.
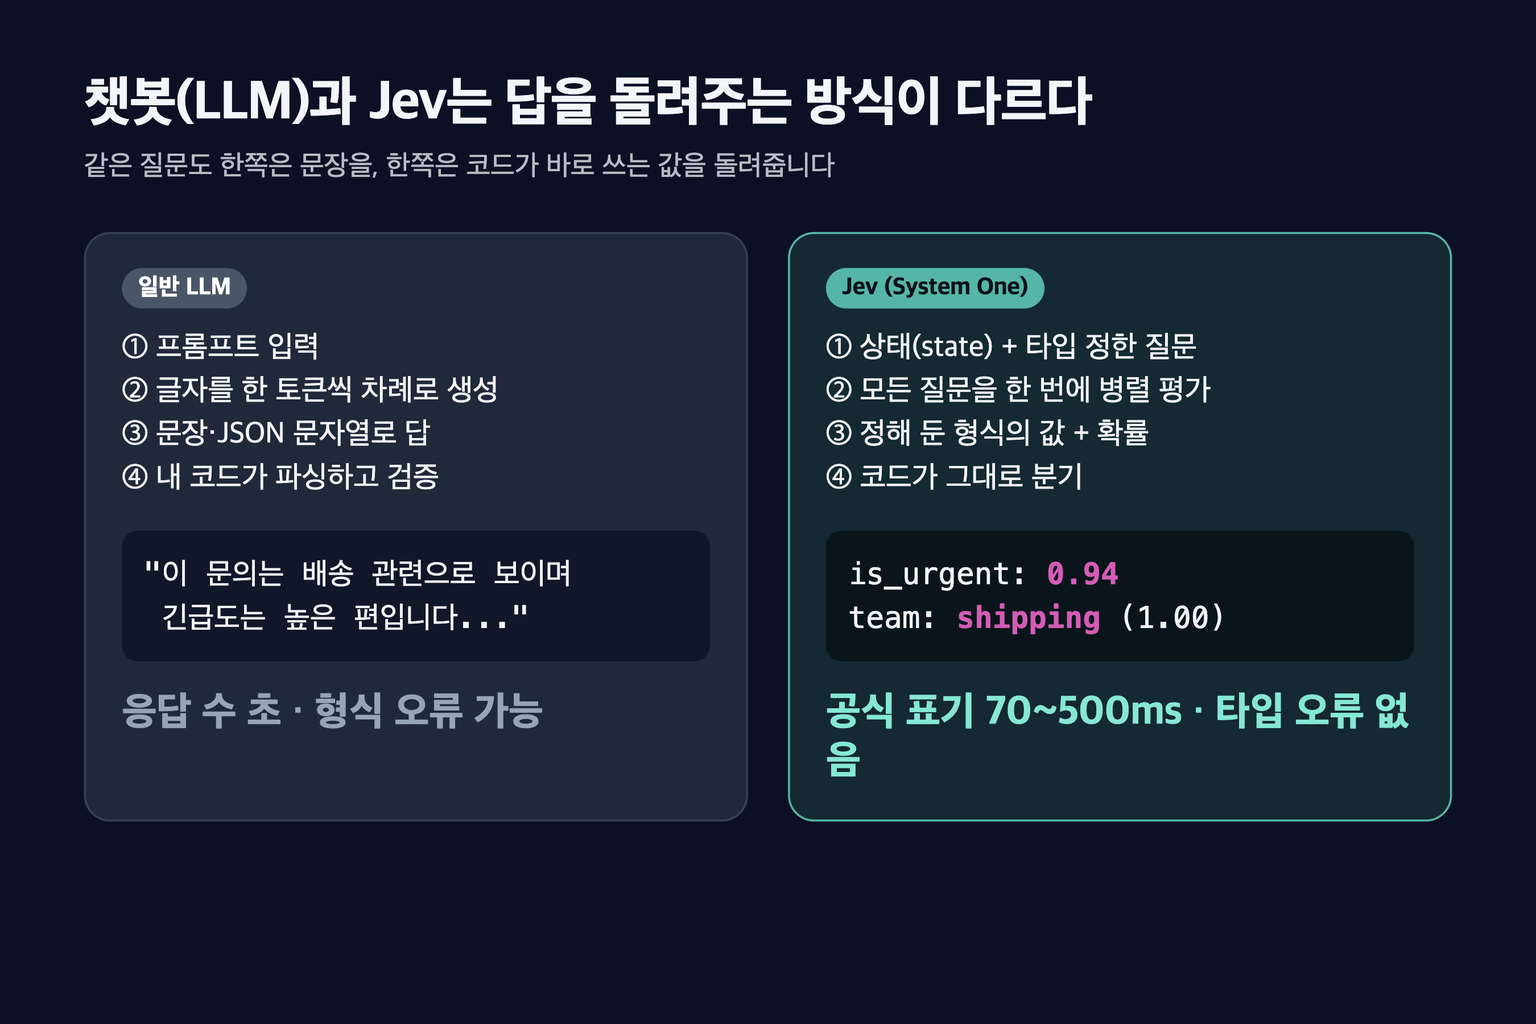
| 구분 | 일반 LLM(챗봇) | Jev(System One) |
|---|---|---|
| 돌려주는 것 | 문장, 코드, JSON 문자열 | 예·아니오 확률, 보기 선택, 단계 점수 |
| 생성 방식 | 토큰을 하나씩 순서대로 | 모든 질문을 한 번에 병렬로 |
| 형식 오류 | 가능(파싱·검증 필요) | 공식 설명상 타입 오류 없음 |
| 확신 정도 | 물어봐도 과신하기 쉬움 | 확률과 신뢰도를 항상 함께 제공 |
| 잘하는 일 | 글쓰기, 코딩, 대화, 추론 | 분류, 라우팅, 점수화, 검증, 가드레일 |
| 못하는 일 | 빠르고 싼 대량 판정 | 글 생성, 계산, 여러 단계 추론 |
TypeSafe는 학습 방식도 다르다고 설명합니다. 사람이 선호하는 답에 맞추는 RLHF 대신, 확률이 실제 정답률과 맞도록 훈련하는 RLCD(보정된 판정을 위한 강화학습)를 새로 만들었다는 것입니다.
얼마나 빠르고 싼가
공식 발표문이 내세우는 숫자는 응답 시간 70~500ms, 입력 100만 토큰당 0.042달러, 출력 토큰 무료입니다. 10억 토큰으로 환산하면 42달러입니다.
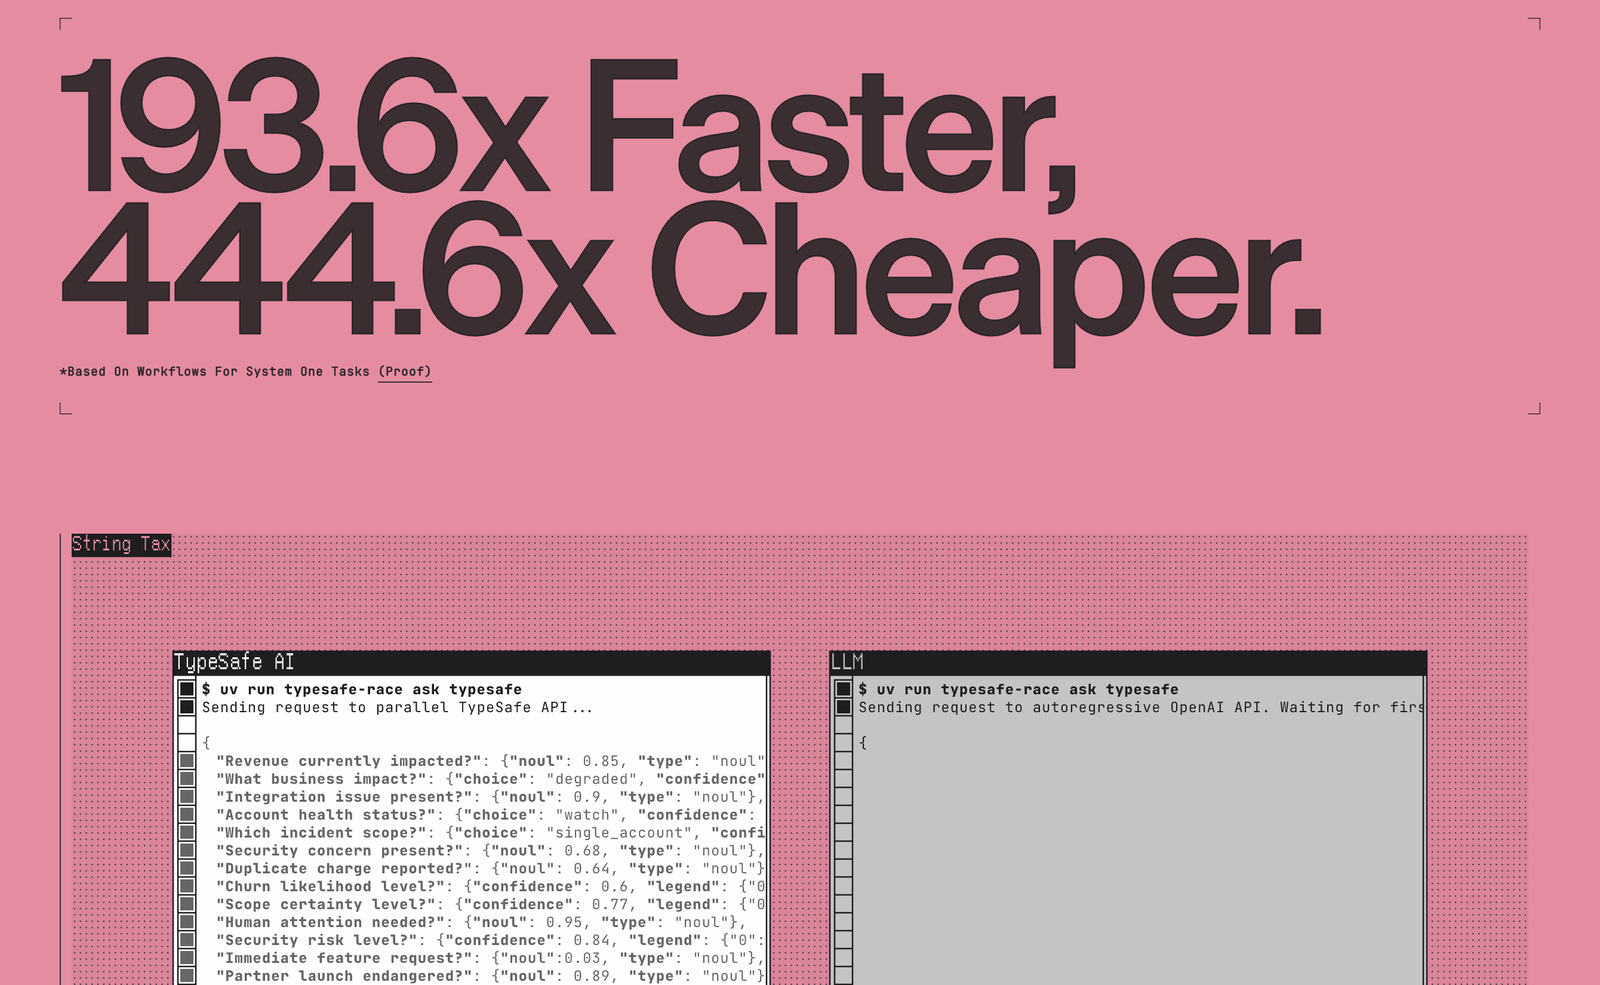
홈페이지의 "193.6배 빠르고 444.6배 싸다"는 문구도 눈에 띕니다. 다만 발표문 스스로 이 수치는 자사가 만든 워크플로 평가에서 나왔고, 실제 환경에서는 상한에 가까운 값일 것이라고 단서를 달았습니다. 광고 문구보다는 "자릿수가 다르다" 정도로 받아들이는 편이 안전합니다.
감을 잡기 위해 계산해 봤습니다. 제가 플레이그라운드에서 돌린 짧은 고객 문의 한 건이 입력 약 450토큰이었습니다. 이런 요청 1만 건이면 450만 토큰, 비용은 약 0.19달러입니다.
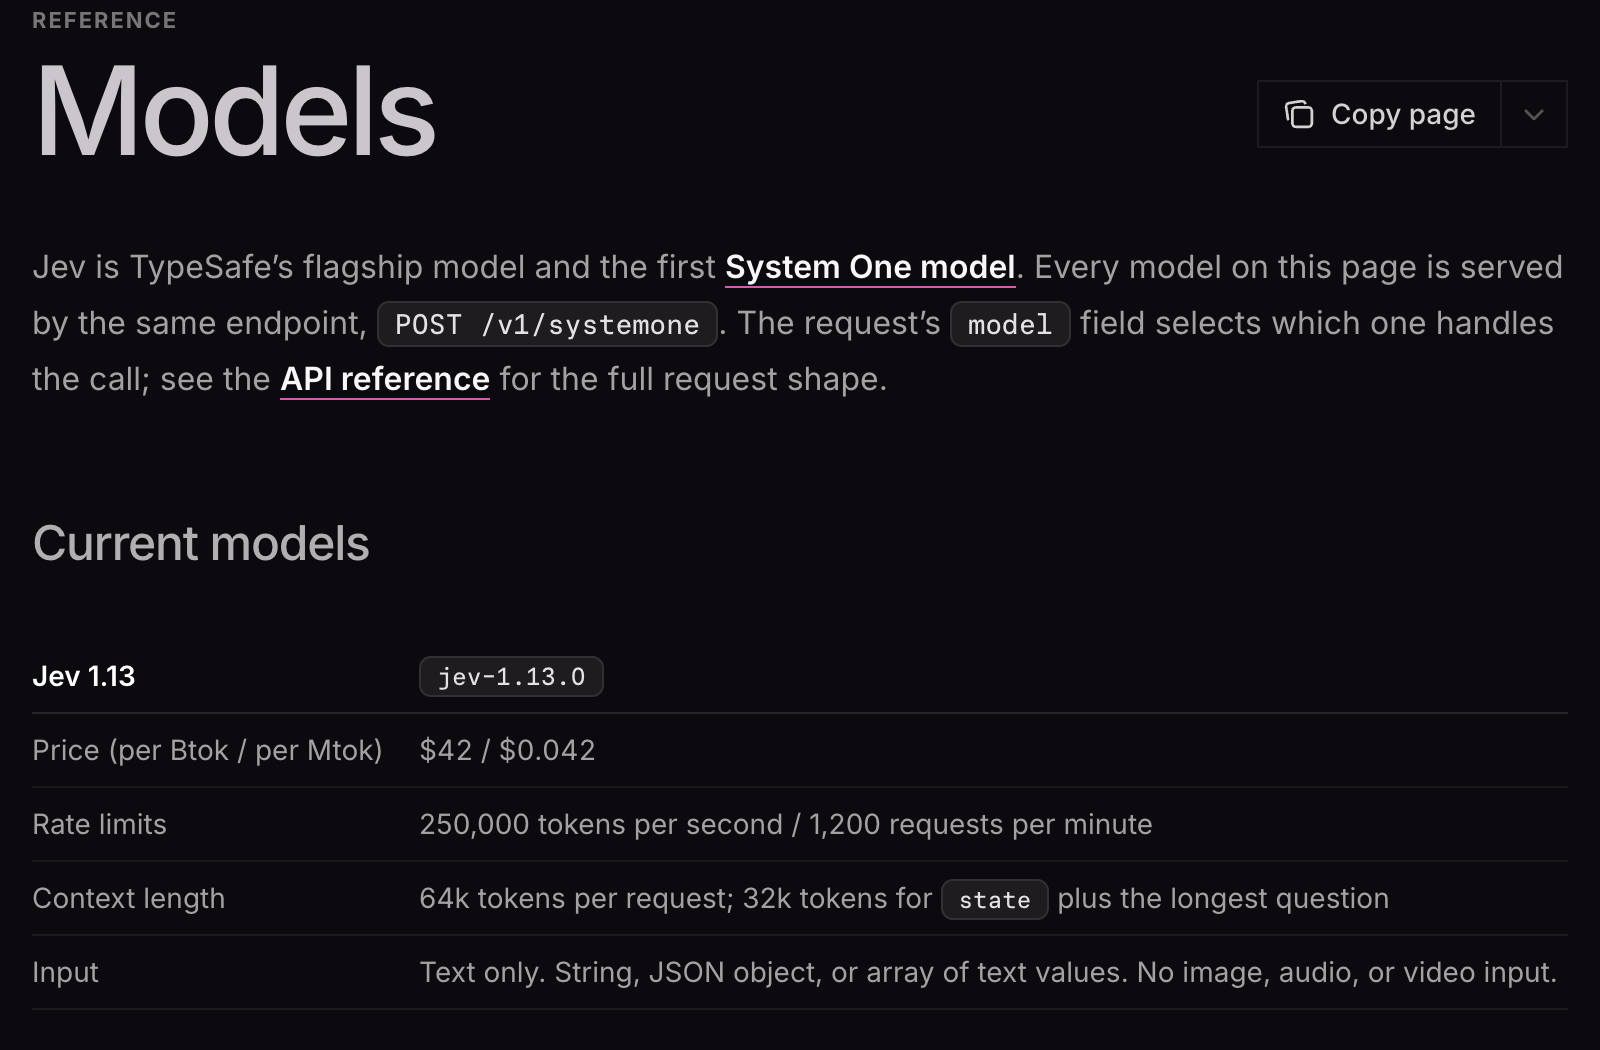
| 항목 | 공식 문서 값(Jev 1.13) |
|---|---|
| 모델 ID | jev-1.13.0 (별칭 jev-latest) |
| 가격 | 입력 100만 토큰당 0.042달러, 출력 무료 |
| 속도 제한 | 초당 25만 토큰, 분당 1,200회 (수요에 따라 수시 조정) |
| 컨텍스트 | 요청당 64k 토큰, 상태+가장 긴 질문 32k 토큰 |
| 입력 | 텍스트만(문자열, JSON 객체, 텍스트 배열). 이미지·음성 불가 |
별칭 jev-latest는 새 버전이 나오면 자동으로 옮겨 갑니다. 기준선을 특정 버전에 맞춰 조정했다면 jev-1.13.0처럼 버전을 고정하라는 것이 공식 권고입니다.
공식 사이트와 헷갈리는 사이트 구분하기
Jev가 화제가 되자 비슷한 이름의 사이트가 빠르게 생겼습니다. 검색 상위에 나오는 jevtypesafeai.com은 페이지 하단에 "TypeSafe AI와 제휴하지 않았다"고 적혀 있습니다. API 주소와 요금 체계도 공식과 다릅니다.
| 용도 | 공식 주소 |
|---|---|
| 소개·발표문 | typesafe.ai |
| 문서 | docs.typesafe.ai |
| 로그인·플레이그라운드·API 키 | console.typesafe.ai |
| API 엔드포인트 | api.typesafe.ai/v1/systemone |
API 키나 결제 정보를 넣기 전에 주소창부터 확인하세요. 제3자 블로그에 적힌 모델명이나 엔드포인트를 그대로 복사하면 오류가 나는 경우도 있습니다.
PART 02
사용법: 플레이그라운드부터 API까지
시작 전 준비: 계정과 대기자 명단
9월 27일 확인한 공식 홈페이지 첫 화면에는 "TypeSafe는 다시 초대제로 운영 중"이라는 문구와 대기자 명단 입력란이 떠 있습니다. 이미 계정이 있는 사람은 로그인해서 바로 쓸 수 있고, 새로 시작하는 사람은 이메일을 남기고 차례를 기다려야 합니다.
계정이 생기면 콘솔 왼쪽 메뉴에서 Playground, Usage, API Keys, Billing을 볼 수 있습니다. 코드 없이 시험하려면 Playground, 프로그램에 붙이려면 API Keys에서 키를 만듭니다.
1단계: 플레이그라운드에서 3분 만에 써 보기
플레이그라운드는 왼쪽에 상태, 가운데에 질문, 오른쪽에 결과가 나오는 구조입니다. 오른쪽 예제 목록에는 "핫도그는 샌드위치인가" 같은 입문 예제와 이력서 심사, 상담원 대화 감사, LLM 가드레일 같은 실무 예제가 들어 있습니다.
- State 칸에 판단할 텍스트를 붙여 넣습니다. 저는 택배 지연 문의 하나를 넣었습니다.
- Questions 칸에서 Noul·Score·Choice 중 하나를 고르거나 JSON으로 질문을 직접 씁니다.
- 아래쪽 모델 선택이
jev-latest인지 확인하고 Run을 누릅니다. - 오른쪽 Overview에서 결과를 보고, JSON 탭에서 실제 응답 형식을 확인합니다.
제가 넣은 질문은 세 개였습니다. 오늘 안에 답이 필요한지(Noul), 어느 팀이 맡을지(Choice), 고객이 얼마나 화가 났는지(Score)입니다. 상태는 한국어로 쓰고 질문은 영어로 적었습니다.
{
  "is_urgent": {
    "type": "noul",
    "instructions": "Does the customer need a reply today or within a hard deadline?"
  },
  "department": {
    "type": "choice",
    "instructions": "Which team should handle this message?",
    "criteria": {
      "shipping": "Delivery delay, tracking, or courier problems",
      "refund": "Refund, cancellation, or payment problems",
      "product": "Product defect or usage questions"
    }
  },
  "frustration": {
    "type": "score",
    "instructions": "How frustrated is the customer?",
    "criteria": [
      "Calm, just stating facts",
      "Frustrated but civil",
      "Very angry, strong language or threatening to leave"
    ]
  }
}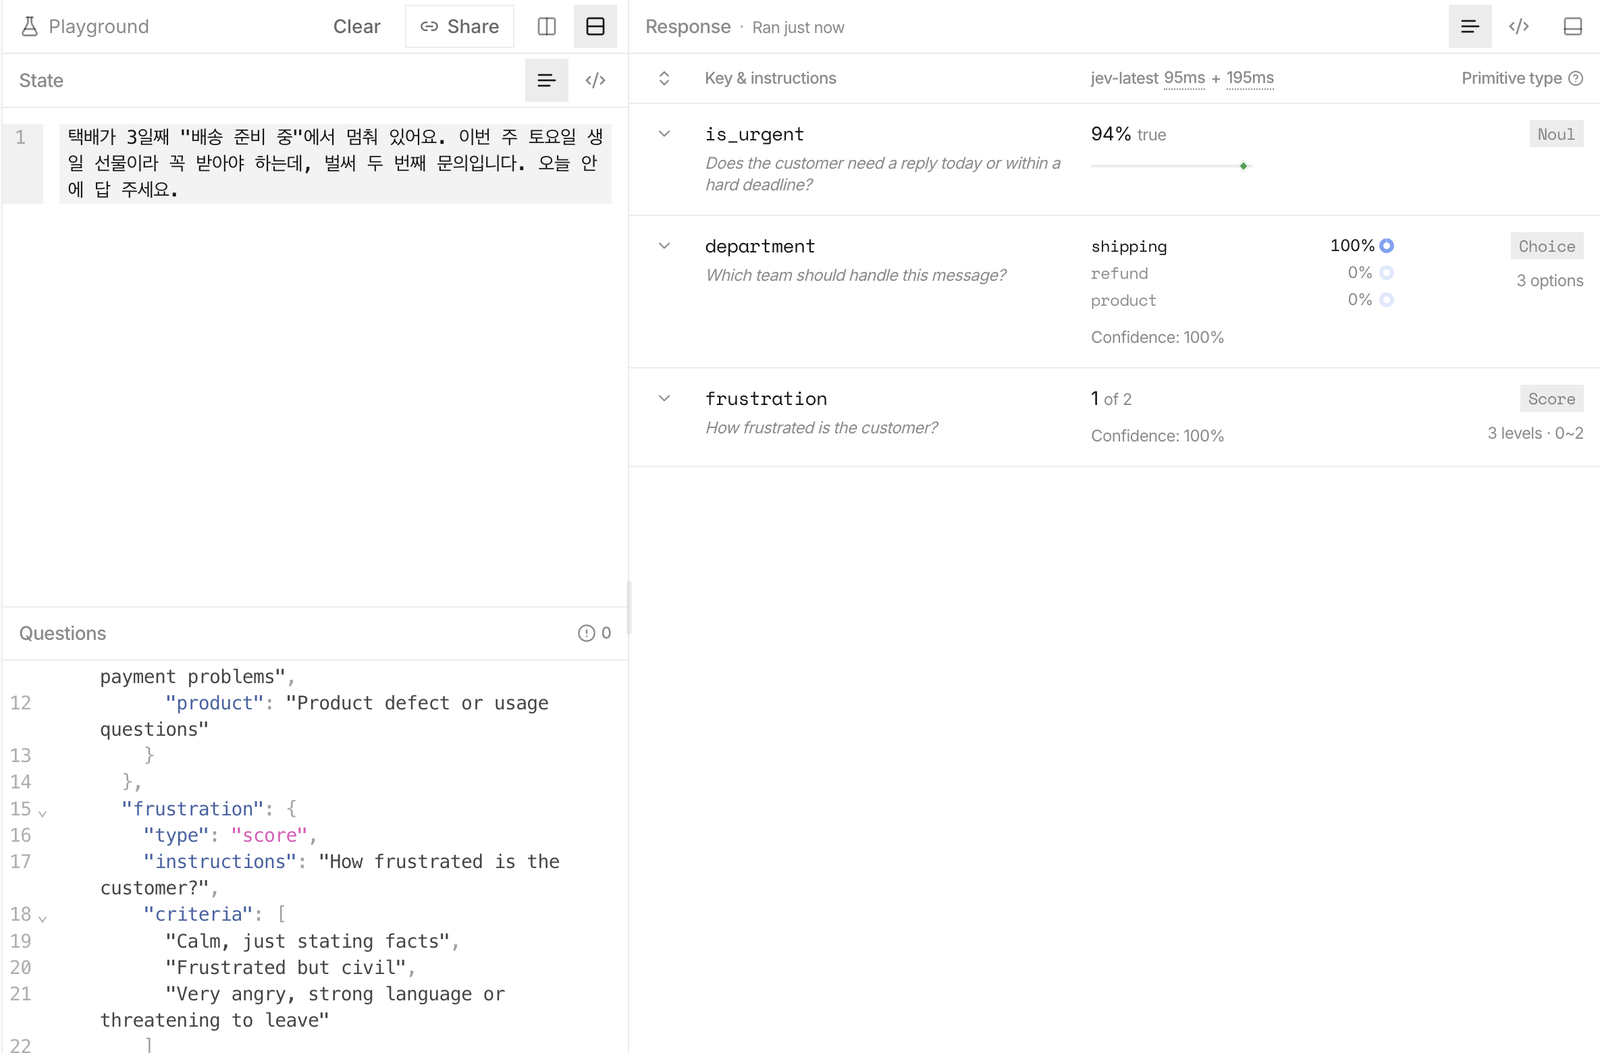
결과는 순식간에 나왔습니다. 화면에는 약 95ms가 찍혔고, 긴급 여부 94%, 담당 팀은 배송팀 100%, 화남 정도는 "짜증 났지만 예의는 지킴" 단계로 나왔습니다. 같은 질문에 문장만 바꿔 두 건을 더 넣어 봤습니다.
| 넣은 문의(요약) | 긴급(Noul) | 담당 팀(Choice) | 화남 정도(Score 0~2) |
|---|---|---|---|
| 3일째 배송 준비 중, 토요일 생일 선물이라 오늘 답 달라 | 0.94 | 배송 1.00 | 1.0 (신뢰도 1.00) |
| 머그컵 잘 받았다, 같은 색 하나 더 사면 이번 주에 오나 | 0.37 | 배송 0.96 | 0.0 (신뢰도 1.00) |
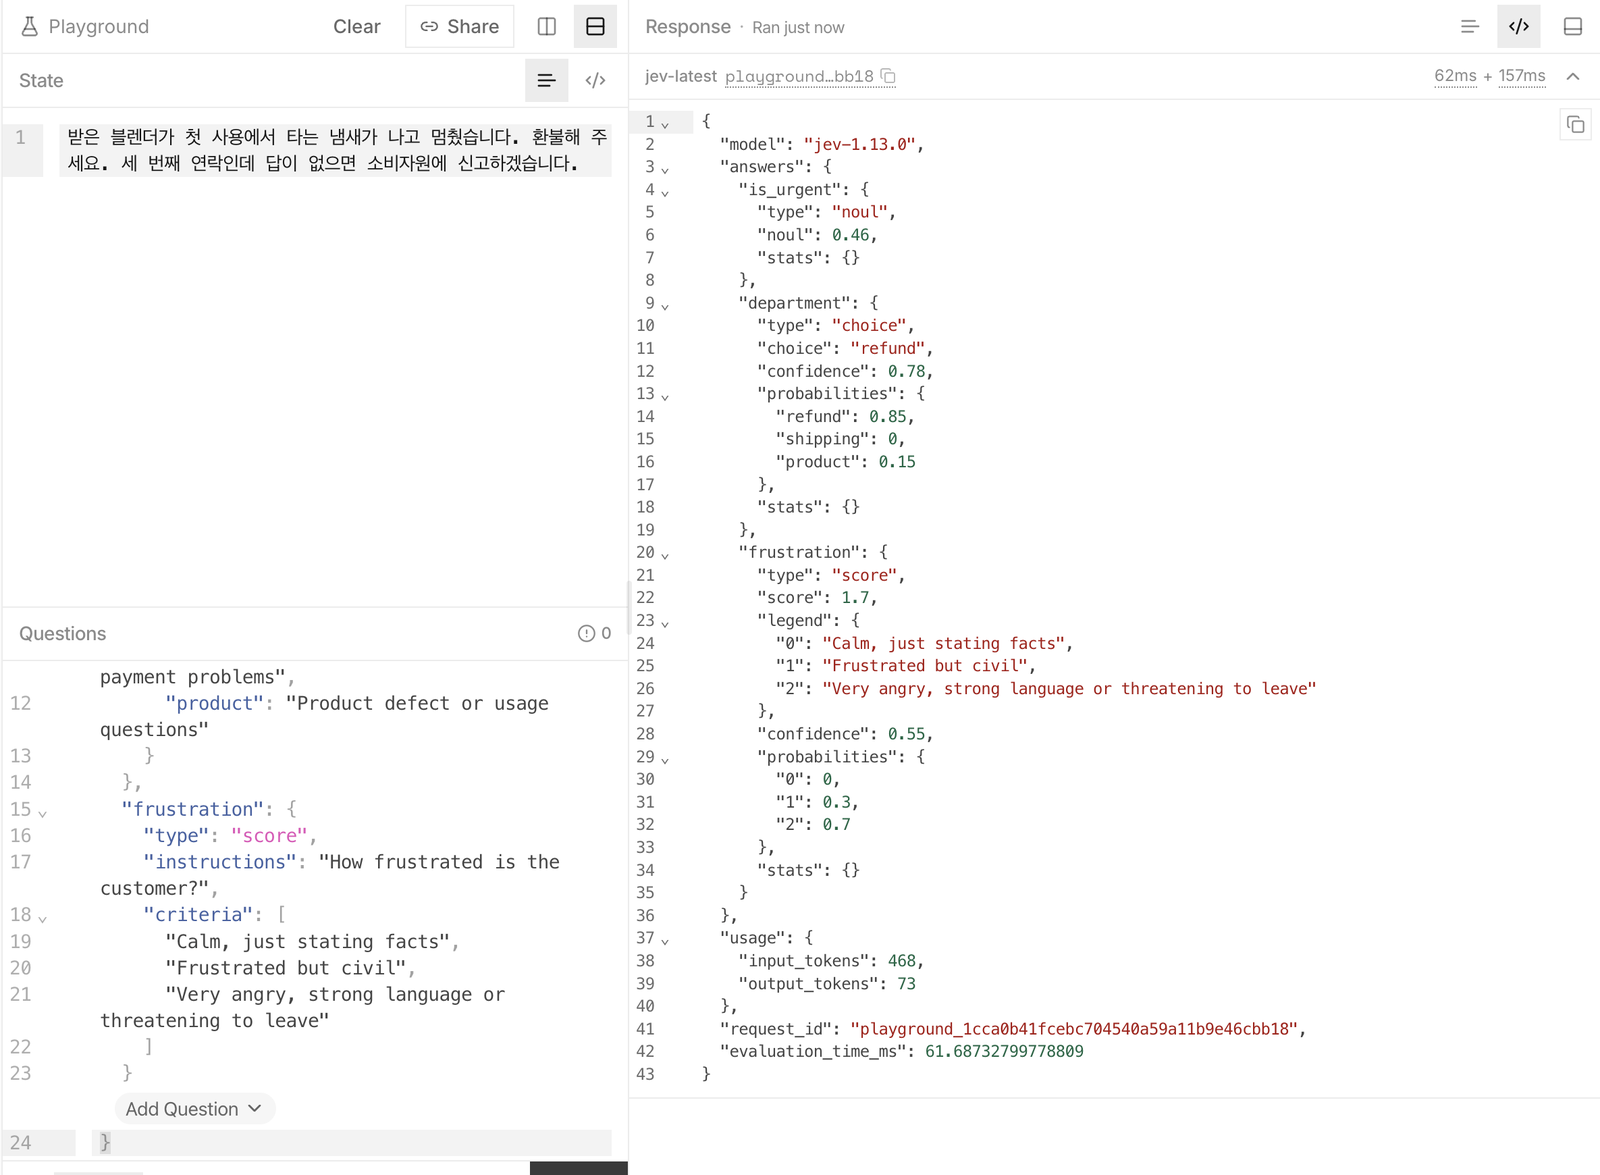
| 블렌더가 첫 사용에 타는 냄새, 환불해 달라, 세 번째 연락 | 0.46 | 환불 0.85 / 제품 0.15 | 1.7 (신뢰도 0.55) |
세 번째 결과가 흥미롭습니다. 화남 점수 1.7은 "짜증"과 "매우 화남" 사이에서 모델이 70% 대 30%로 갈렸다는 뜻이고, 그래서 신뢰도도 0.55로 낮게 나왔습니다. 이런 애매한 건을 골라내는 데 신뢰도를 쓰는 법은 PART 03에서 다룹니다.
Jev에게 던질 수 있는 질문 세 가지
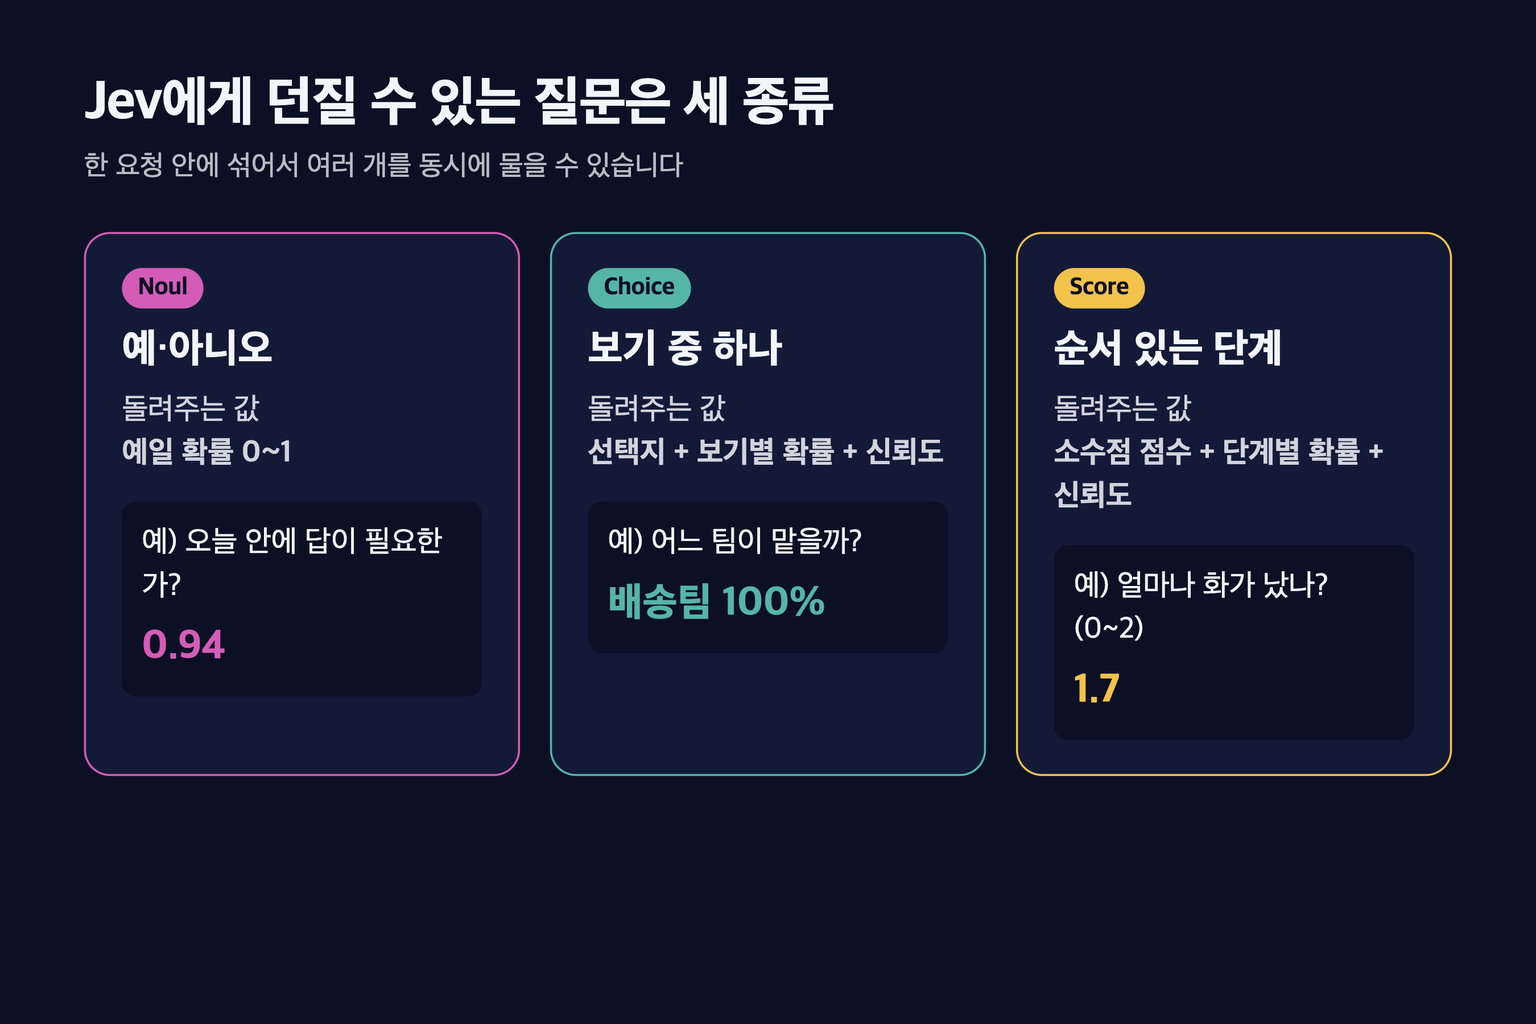
질문 유형은 세 가지뿐입니다. 답의 모양이 어떤지에 따라 고르면 됩니다.
| 유형 | 언제 쓰나 | 필수 항목 | 돌려받는 값 |
|---|---|---|---|
| Noul | 예·아니오로 답이 갈릴 때 | instructions (criteria 선택) | noul: 예일 확률 0~1 |
| Choice | 정해진 보기 중 하나를 고를 때(최대 255개) | instructions + criteria(보기별 설명) | choice, 보기별 확률, confidence |
| Score | 순서가 있는 단계로 평가할 때(2~10단계) | instructions + criteria(낮은 단계부터 배열) | score(소수 가능), 단계별 확률, legend, confidence |
Score의 점수는 단계 번호에 확률을 곱해 더한 값입니다. 예를 들어 0단계 0, 1단계 0.3, 2단계 0.7이면 0×0 + 1×0.3 + 2×0.7 = 1.7이 됩니다. 그래서 같은 1.0이라도 "1단계 확정"일 수도, "0단계와 2단계 반반"일 수도 있습니다. 점수만 보지 말고 확률 분포를 같이 봐야 하는 이유입니다.
공식 문서가 강조하는 요령도 있습니다. Score 단계는 "보통 심각함"처럼 정도로 쓰지 말고 "기능이 고장 났지만 우회 방법이 있음"처럼 상황으로 써야 합니다. 모델은 각 단계를 번호 없이 따로따로 보기 때문에, 단계에 숫자만 적으면 판단 근거가 사라집니다.
2단계: API로 직접 호출하기
프로그램에 붙이려면 콘솔의 API Keys에서 키를 만든 뒤 환경 변수 TYPESAFE_API_KEY에 넣습니다. 요청은 POST 한 번이고, 본문은 model, state, questions 세 가지면 됩니다.
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": "택배가 3일째 배송 준비 중입니다. 토요일 선물이라 오늘 답 주세요.",
    "questions": {
      "is_urgent": {
        "type": "noul",
        "instructions": "Does the customer need a reply today?"
      }
    }
  }'
응답은 요청 때 붙인 질문 이름을 그대로 키로 씁니다. Noul은 noul 값 하나, Choice와 Score는 확률과 신뢰도가 함께 옵니다. usage에는 입력·출력 토큰 수가 담겨 비용 계산에 바로 쓸 수 있습니다.
질문 이름은 모델에 전달되지 않는다는 점도 알아 두면 좋습니다. is_urgent라는 키는 결과를 찾아 쓰기 위한 내 표시일 뿐, 판단은 오직 instructions와 criteria 문장으로 이뤄집니다.
3단계: 파이썬·자바스크립트 SDK로 쓰기
공식 SDK를 쓰면 질문과 답이 타입으로 잡히고, 요청 한도에 걸렸을 때 자동 재시도도 해 줍니다. 파이썬은 3.10 이상, 자바스크립트는 Node.js 20 이상이 필요합니다.
pip install typesafe-sdk

from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()  # TYPESAFE_API_KEY를 자동으로 읽음
res = client.system_one(
    state="블렌더가 첫 사용에 타는 냄새가 나고 멈췄습니다. 환불해 주세요.",
    questions={
        "wants_refund": Noul(instructions="Is the customer asking for a refund?"),
        "team": Choice(
            instructions="Which team should handle this?",
            criteria={"shipping": "Delivery problems",
                      "refund": "Refund or payment",
                      "product": "Product defect"},
        ),
    },
)
print(res.answers["wants_refund"].noul, res.answers["team"].choice)
npm install @typesafe-ai/sdk
import { choice, TypeSafeClient } from "@typesafe-ai/sdk";
const client = new TypeSafeClient();
const res = await client.systemOne({
state: { message: "결제가 두 번 됐어요. 빨리 확인해 주세요." },
questions: {
team: choice("Which team should handle this?", {
billing: null, shipping: null, other: null,
}),
},
});
console.log(res.answers.team.choice);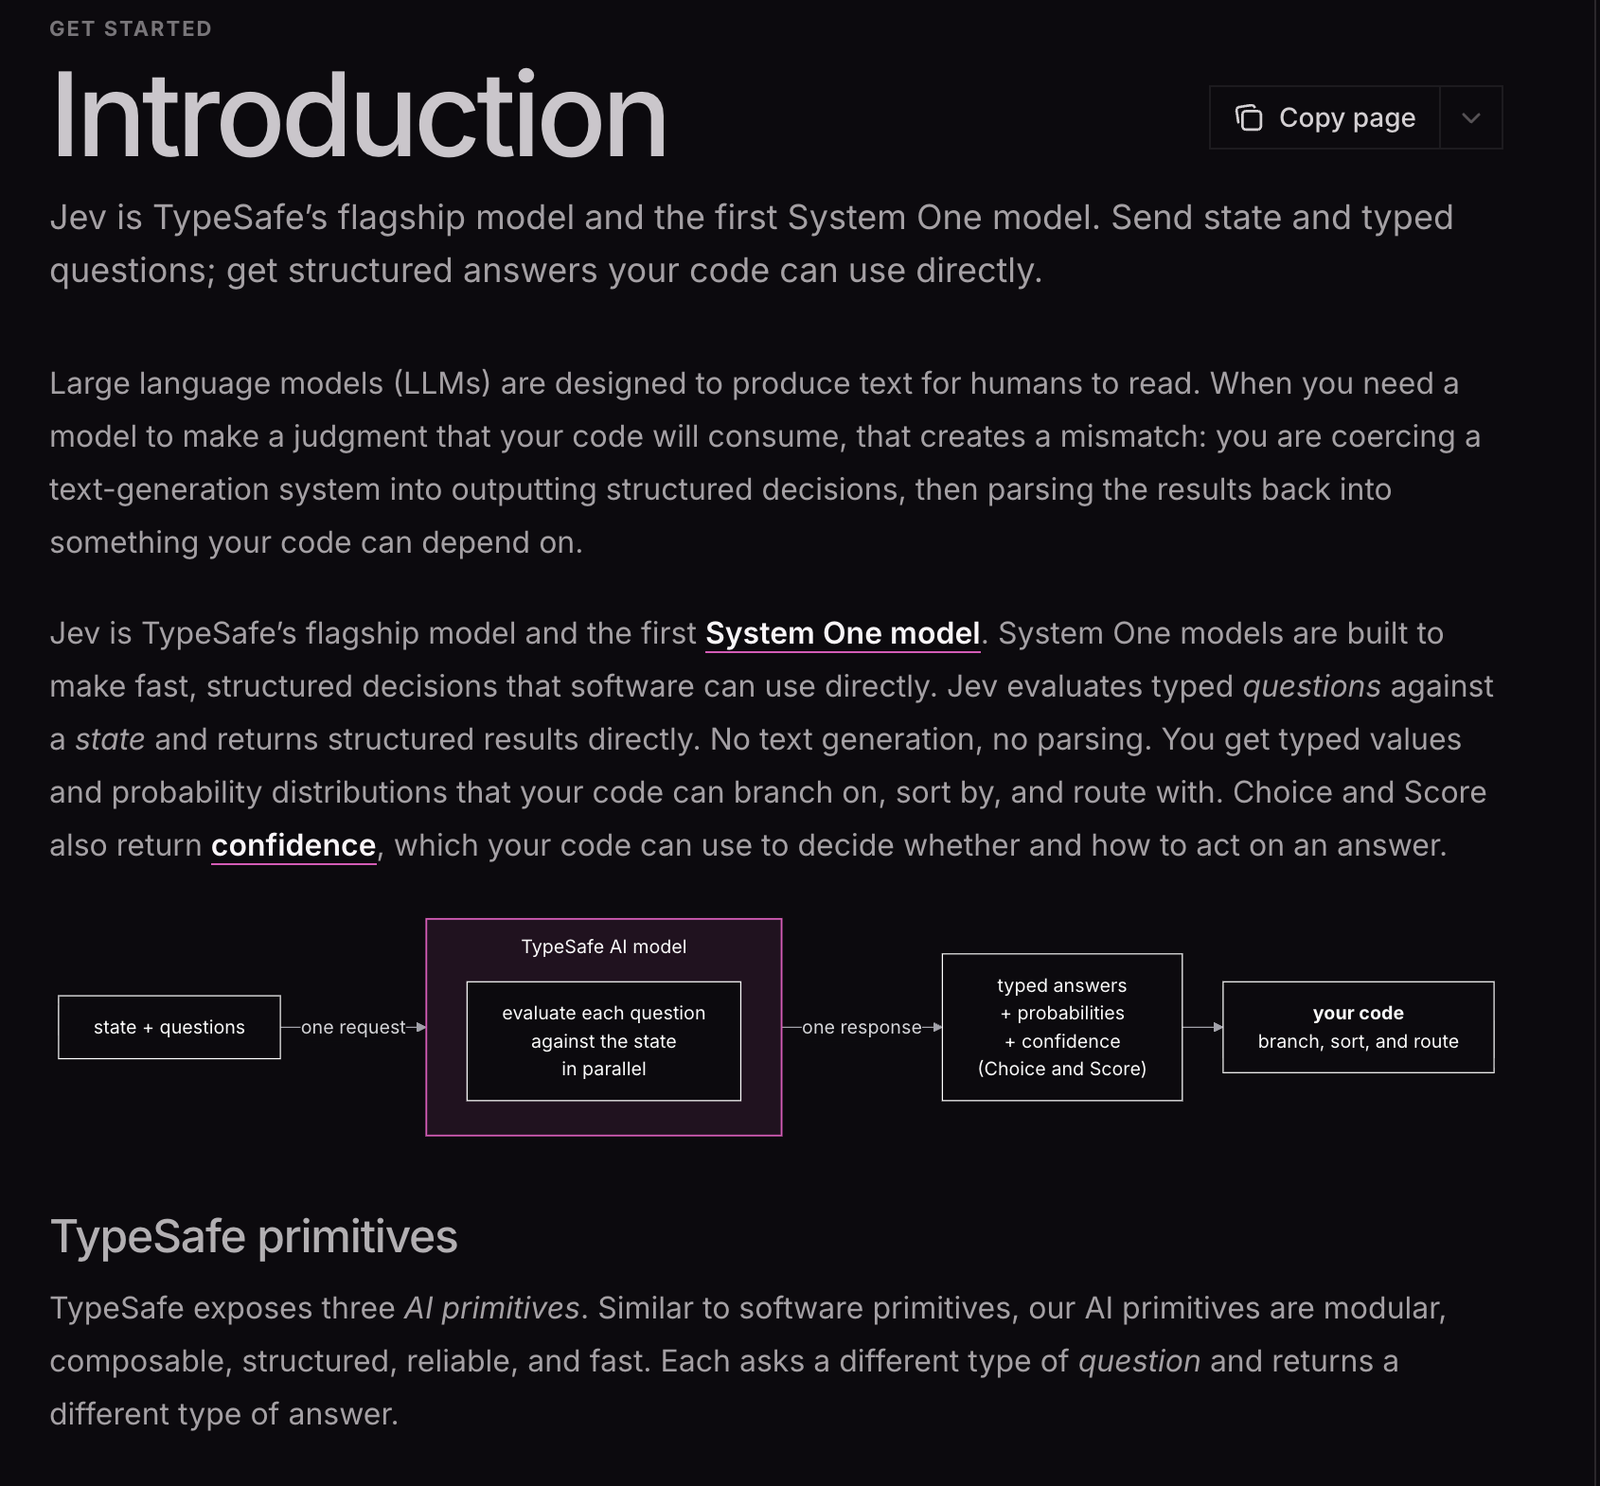
코딩 에이전트에 붙여서 쓰기
직접 코드를 짜기 번거롭다면 코딩 에이전트에게 맡기는 방법도 있습니다. TypeSafe는 요청·응답 형식을 담은 공식 에이전트 스킬을 배포합니다.
# Claude Code
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai

# Codex 등 다른 에이전트
npx skills add typesafe-ai/skills --skill typesafe-ai
설치 후에는 "TypeSafe 스킬을 참고해서 댓글을 광고·질문·후기로 분류하는 스크립트를 만들어 줘"처럼 요청하면 됩니다. 스킬 없이 맡기면 에이전트가 예전 형식이나 비공식 문서를 참고해 틀린 코드를 짜는 일이 생길 수 있습니다.
처음 호출할 때 자주 막히는 부분
| 증상 | 원인 | 해결 |
|---|---|---|
| 422 Input should be a valid dictionary | questions를 배열로 보냄 | 질문 이름을 키로 하는 객체로 보내기 |
| 400 must have criteria or instructions | 질문 문구를 question 같은 다른 필드에 넣음 | 문구는 instructions 필드에 |
| 401 인증 오류 | 키 누락·오타, Bearer 빠짐 | Authorization: Bearer 키 형식 확인 |
| 403 차단(Cloudflare 1010) | 일부 HTTP 도구의 기본 User-Agent가 막히는 경우 | 브라우저형 User-Agent와 Accept: application/json 헤더 추가 |
| 429 Too Many Requests | 초당 토큰·분당 요청 한도 초과 | SDK 자동 재시도 사용, retry-after 대기 |
| 모델을 찾을 수 없음 | 비공식 글에 적힌 모델명 사용 | jev-latest 또는 jev-1.13.0 |
403 항목은 공식 문서가 아니라 제가 직접 겪고 해결한 경우입니다. 같은 코드가 어떤 환경에선 되고 어떤 환경에선 막힌다면 헤더부터 의심해 보세요.
PART 03
활용법: 숫자를 결정으로 바꾸기
결과 숫자 읽는 법: 확률과 신뢰도
Jev가 주는 숫자는 두 종류입니다. 확률은 "무엇이 답인가"를, 신뢰도(confidence)는 "그 답을 믿고 움직여도 되나"를 알려 줍니다.
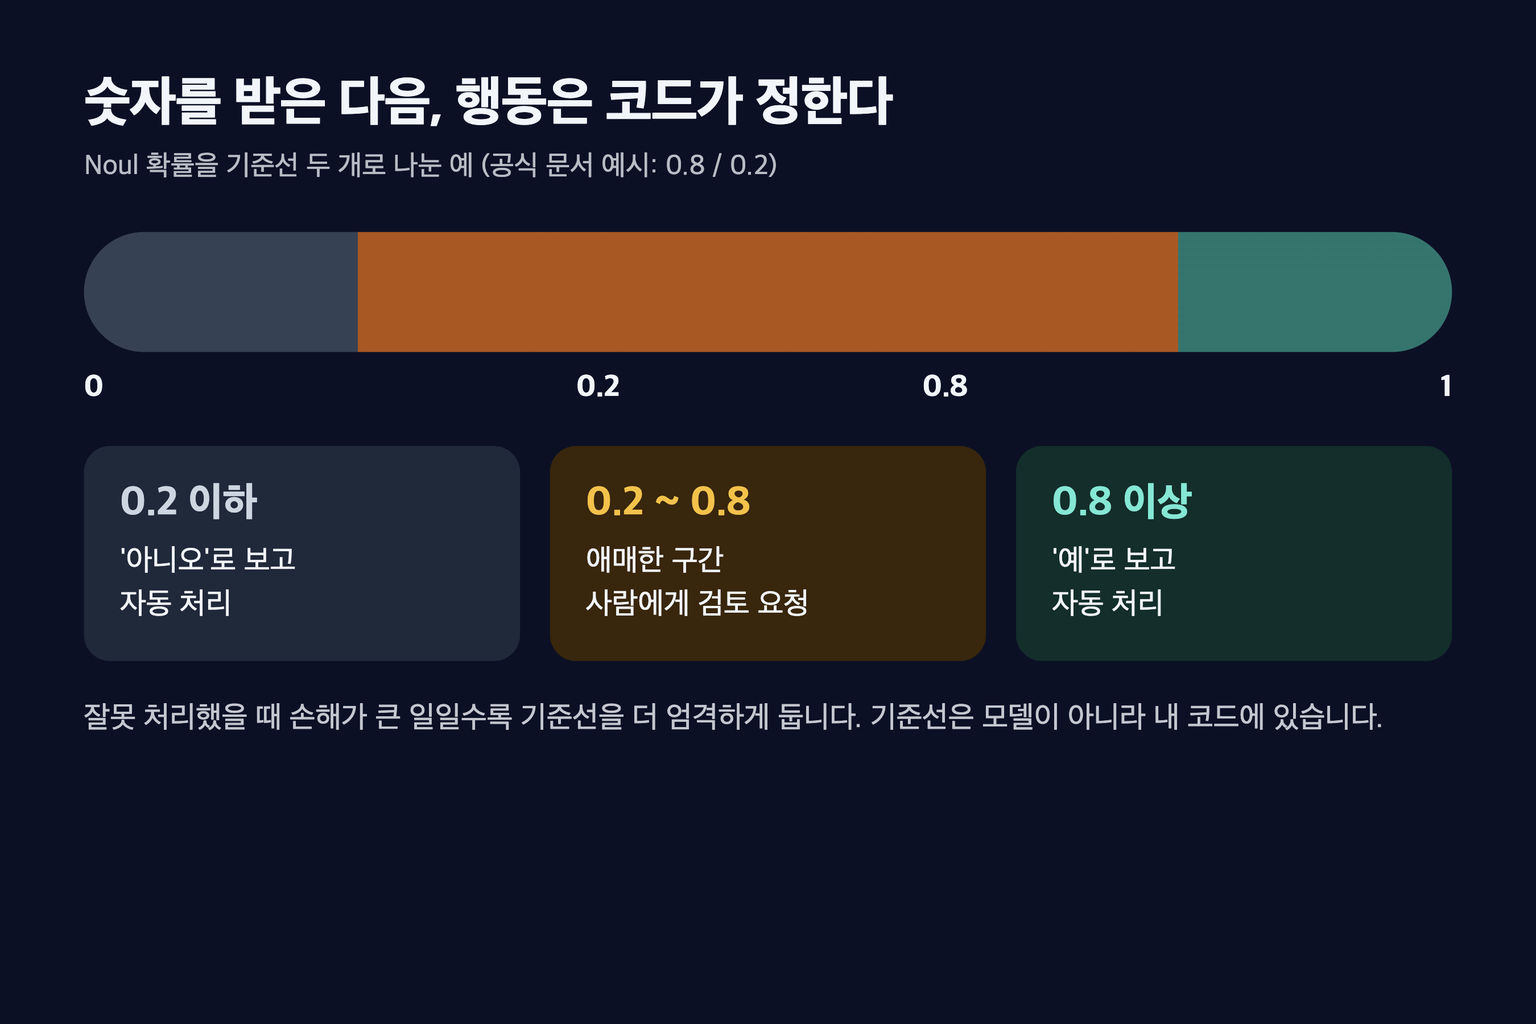
Noul은 값 자체가 답이자 확신입니다. 1에 가까우면 강한 예, 0에 가까우면 강한 아니오, 0.5 근처면 모델도 갈팡질팡한다는 뜻입니다. Choice와 Score는 확률이 한 곳에 몰릴수록 신뢰도가 1에 가깝고, 여러 보기에 퍼질수록 낮아집니다.
반응형
공식 문서가 권하는 기본 설계는 세 갈래입니다. 확신이 높으면 자동 처리, 중간이면 확인을 받거나 표시만, 낮으면 사람에게 넘깁니다. 기준선은 모델이 아니라 내 코드에 두고, 틀렸을 때 손해가 큰 행동일수록 엄격하게 잡습니다.
YES, NO = 0.8, 0.2   # 기준선은 코드에 둔다

p = res.answers["wants_refund"].noul
if p >= YES:
    route("refund_auto")        # 확실한 예
elif p <= NO:
    route("normal_queue")       # 확실한 아니오
else:
    route("human_review")       # 애매하면 사람에게
실무 팁 하나를 덧붙이면, 모델이 돌려준 원래 숫자와 기준선을 따로 저장해 두세요. 나중에 기준선을 0.8에서 0.75로 바꾸고 싶을 때 모델을 다시 부르지 않고도 기존 결과를 새 기준으로 다시 나눌 수 있습니다.
기준선은 감으로 정하지 말고 정답을 아는 예시로 맞춥니다. 확실히 통과해야 할 예시 몇 개와 확실히 떨어져야 할 예시 몇 개를 넣어 보고, 두 무리가 깔끔하게 갈리는 지점을 찾는 식입니다.
공식 문서가 소개하는 활용 패턴 네 가지
| 패턴 | 핵심 아이디어 | 이럴 때 |
|---|---|---|
| 한 번에 많이 묻기(fan-out) | 필요할지 모르는 질문까지 한 요청에 몰아서 묻고, 코드가 골라 씀 | 질문이 늘어도 요청 수·속도를 유지하고 싶을 때 |
| 신뢰도 기반 분기 | 답은 무엇을, 신뢰도는 실행 여부를 결정 | 자동 처리와 사람 검토를 섞을 때 |
| 복합 점수 | 판단을 작은 Score 여러 개로 쪼개고 가중치 합산 | 우선순위·품질 점수처럼 요인이 여럿일 때 |
| 의도 라우팅 | 요청을 분류해 규칙·전문 LLM·사람 중 알맞은 곳으로 | 챗봇·상담 앞단의 교통정리 |
fan-out은 비용 면에서도 효과가 큽니다. 공식 쿡북에서는 GDPR 문서에 대한 질문 13개를 따로따로 보내는 대신 한 요청에 묶었더니 12.2배 싸고 10배 빨랐으며 답은 달라지지 않았다고 보고합니다. 상태를 한 번만 읽고 질문을 병렬로 평가하기 때문입니다.
복합 점수는 이렇게 씁니다. "이 버그 신고의 우선순위"를 한 번에 묻지 않고 심각도, 고객의 화남 정도, 신고의 구체성을 각각 Score로 받은 뒤 0~1로 정규화해 0.6·0.3·0.1 같은 가중치로 더합니다. 순위가 팀 판단과 다르면 모델이 아니라 가중치를 고칩니다.
이런 곳에 써 보세요
| 분야 | Jev에게 물을 질문 예 | 결과로 할 일 |
|---|---|---|
| 고객 문의 | 긴급한가(Noul), 담당 팀(Choice), 화남 정도(Score) | 자동 배정, 급한 건 먼저 |
| 댓글·게시판 | 광고인가, 욕설이 있나, 질문인가 | 숨김·검토·답변 대기로 분류 |
| RAG 검색 | 이 문단이 질문에 답이 되나 | 관련 없는 문단을 LLM에 넘기기 전에 제거 |
| 인용 검증 | 이 인용이 원문의 주장을 뒷받침하나 | 근거 없는 인용 표시 |
| LLM 가드레일 | 탈옥 시도인가, 위험 요청인가 | 통과·검토·차단 |
| 데이터 정리 | 두 상품 기록이 같은 제품인가 | 중복 병합 후보 추리기 |
| 콘텐츠 운영 | 이 소재가 내 채널 주제에 맞나, 기존 글과 겹치나 | 기획 후보 1차 선별 |
공통점은 "사람이면 몇 초면 판단하지만 규칙으로 짜기는 애매한 일"이 대량으로 반복된다는 것입니다. 한두 건이면 챗봇에 물어도 되지만, 수천 건을 매일 거르려면 속도와 비용이 전혀 다른 문제가 됩니다.
공식 쿡북의 재정렬 사례도 참고할 만합니다. 법률 문서 검색에서 BM25로 뽑은 후보 30개를 Jev로 다시 채점하자 1위 정확도가 5%에서 18%로, 상위 10개 정확도가 38%에서 62%로 올랐다고 합니다.
Jev에게 맡기면 안 되는 일
TypeSafe는 Jev 1.13의 약점을 문서로 따로 공개했습니다. 요약하면 "계산과 생성은 코드나 다른 모델에게"입니다.
| 약점 | 예 | 대신 이렇게 |
|---|---|---|
| 글자 그대로 읽음 | 부정·범위를 넣은 질문을 의도와 다르게 해석 | 조건을 정확히 쓰고, 경계 사례를 criteria에 |
| 숫자·계산 | 개수 세기, 색상 코드 비교 | 계산은 코드로, 모델엔 의미 판단만 |
| 날짜 비교 | 어느 날이 먼저인가, 기간 안인가 | 연·월·일을 Choice로 뽑고 비교는 코드로 |
| 여러 단계 추론 | 속성의 속성을 묻는 질문 | 질문을 쪼개 한 단계씩 |
| 쓸데없이 긴 입력 | 관련 없는 내용이 섞인 상태 | 필요한 부분만 걸러서 전달 |
| 악의적 입력 | 본문 속 지시문이 판단을 흔듦 | criteria를 명확히, 배포 전 경계 사례 시험 |
| 텍스트 생성 | 요약문, 답장 쓰기 | 생성형 모델 사용 |
하나 더 있습니다. 같은 질문을 Noul과 Choice로 각각 물으면 숫자가 다르게 나올 수 있고, "환불 요청인가"와 "환불 외 요청인가"의 확률 합이 1이 되지도 않습니다. Noul에 맞춘 기준선을 Choice에 그대로 옮기지 마세요.
한국어로 쓸 때 알아 둘 점
공식 문서는 영어가 주 학습 언어이고 정확도도 가장 높다고 밝힙니다. 한국어 같은 다른 언어도 처리하지만 같은 수준은 아니니, 내 데이터로 먼저 시험하고 신뢰도를 눈여겨보라고 권합니다.
제 시험에서는 상태를 한국어로, 질문과 보기 설명을 영어로 썼을 때 세 건 모두 사람이 보기에 납득되는 답이 나왔습니다. 다만 세 건으로 일반화할 수는 없습니다. 한국어 업무에 쓰려면 정답을 아는 예시 수십 건으로 기준선을 먼저 맞추는 과정을 건너뛰지 마세요.
Q. 챗GPT에 "JSON으로 답해 줘"라고 하면 되지 않나요?
형식은 비슷하게 받을 수 있지만 두 가지가 다릅니다. Jev는 답 형식이 어긋날 수 없게 설계됐고, 모든 답에 보정된 확률과 신뢰도가 붙습니다. 대량으로 돌릴 때 속도와 비용 차이도 자릿수가 다릅니다.
Q. Jev가 틀릴 수도 있나요?
틀릴 수 있습니다. 공식 FAQ도 이를 인정합니다. 그래서 신뢰도가 낮은 답은 사람에게 넘기고, 정답을 아는 예시로 주기적으로 결과를 점검하는 구조가 필요합니다.
Q. 이미지나 PDF도 판단할 수 있나요?
현재는 텍스트만 받습니다. 이미지·음성·PDF는 먼저 텍스트나 구조화된 필드로 바꿔서 상태에 넣어야 합니다.
다음 실험 예고
Jev를 써 보며 든 생각은 "AI를 대화 상대가 아니라 부품으로 쓰는 감각"입니다. 문장을 받던 자리에 숫자를 받으니, 그 숫자를 어떻게 나눌지가 온전히 내 설계가 됩니다.
다음에는 블로그 댓글을 광고·질문·후기로 자동 분류하는 작은 스크립트를 만들어, 기준선을 바꿀 때 결과가 어떻게 달라지는지 숫자로 보여 드리겠습니다. 계정이 있다면 오늘 플레이그라운드에 내 업무 문장 하나를 넣고 질문 세 개만 던져 보세요.
728x90
반응형
'AI 이야기 > 이렇게 쓴다' 카테고리의 다른 글
| 클로드 코드 세션끼리 대화한다 | 다른 세션에 일을 넘기는 법과 코덱스·agy 비교 (0) | 2026.09.28 |
|---|---|
| Jev 없이 판정 AI 돌리기 | Ollaya·Laya·Privatemode, 정확도와 속도 비교 (0) | 2026.09.28 |
| Opus 5.5로 영상 만들기 | 편집 프로그램 없이 코드로 뽑는 원리와 실전 프롬프트 (0) | 2026.09.27 |
| Opus 5.5, 어디에 써야 본전 뽑나 | 스레드 사례로 본 활용법과 한도 아끼는 법 (0) | 2026.09.27 |
| Opus 5.5가 덜 똑똑해 보인다면 CLAUDE.md부터 | /claude-api prompt-audit 쓰는 법 (0) | 2026.09.27 |


댓글 영역