고정 헤더 영역

상세 컨텐츠
본문
728x90
반응형
Jev를 써 보고 싶어도 9월 27일 기준 신규 가입은 다시 초대제로 운영되고 있습니다. 회사 고객 문의처럼 밖으로 보내기 곤란한 데이터라면 호스팅 API 자체가 부담이기도 합니다.
Jev가 화제가 되자 비슷한 "판정 모델"을 내 컴퓨터에서 돌리거나 다른 LLM으로 흉내 내는 방법이 여럿 나왔습니다. 문장을 쓰지 않고 선택지와 확률만 돌려주는 방식은 같습니다. 세 가지 대표 방법을 공식 문서와 각 프로젝트가 공개한 벤치마크로 비교했습니다.
Jev 대신 쓸 만한 판정 모델은 크게 세 갈래다. 여러 공개 모델을 내 PC에서 돌리는 런타임 Ollaya, 설치형 판정 모델 Laya, 일반 LLM의 첫 토큰 확률을 읽어 판정 모델처럼 쓰는 Privatemode Decisions다. 앞의 둘은 내 컴퓨터에서 돌고 Jev와 같은 API 형식을 지원하며, 세 번째는 호스팅 LLM을 활용한다. 정확도는 모델마다 차이가 크다.
PART 01
판정 모델, 왜 로컬로 돌리나
Jev를 대신할 방법이 필요한 이유
Jev는 판정 한 번에 입력 100만 토큰당 0.042달러로 매우 싸고 빠릅니다. 그래도 로컬 대안을 찾는 이유는 세 가지입니다. 새 가입이 막혀 있을 때가 있고, 데이터를 외부 서버로 보낼 수 없는 업무가 있으며, 이미지처럼 Jev가 받지 않는 입력을 판정하고 싶을 때가 있습니다.
다행히 판정 모델의 원리는 비밀이 아닙니다. 선택지마다 점수를 매겨 확률로 바꾸는 방식이라, 작은 전용 모델을 학습시키거나 일반 LLM이 다음 글자를 고를 때 쓰는 확률을 읽어 오면 비슷한 결과를 낼 수 있습니다.
한 개발자는 블로그에서 이 기법이 "어떤 사람들에게는 오래된 요령"이라며 오픈AI의 logprobs 쿡북을 예로 들었습니다. 새로운 건 기술 자체보다 Jev처럼 쓰기 쉬운 형태로 묶였다는 점입니다.

PART 02
세 가지 방법 살펴보기
1. Ollaya: 판정 모델 전용 실행기
Ollaya는 여러 공개 판정 모델을 내려받아 내 컴퓨터에서 실행하는 오픈소스 도구입니다. 이름처럼 대화형 모델 실행기 Ollama를 떠올리면 쉽지만, 홈페이지는 Ollama나 TypeSafe와 관계없는 독립 프로젝트라고 밝히고 있습니다. 실행기는 Apache-2.0 라이선스입니다.
가장 큰 장점은 호환성입니다. Ollaya는 TypeSafe와 같은 형식의 /v1/systemone 주소를 제공하고, 공식 TypeSafe 파이썬 SDK 0.7.1을 고치지 않고 그대로 붙일 수 있다고 안내합니다. Jev로 짜 둔 코드가 있다면 접속 주소와 모델 이름만 바꿔 연결할 수 있습니다.
# 설치 (macOS·Linux 공식 설치 스크립트)
curl -fsSL https://ollaya.dev/install.sh | sh

# 권장 모델 실행
ollaya run winnow:e4b

# 기존 TypeSafe SDK를 로컬 서버로 연결
export TYPESAFE_BASE_URL=http://localhost:11435
export TYPESAFE_API_KEY=local
export TYPESAFE_DEFAULT_MODEL=winnow:e4b
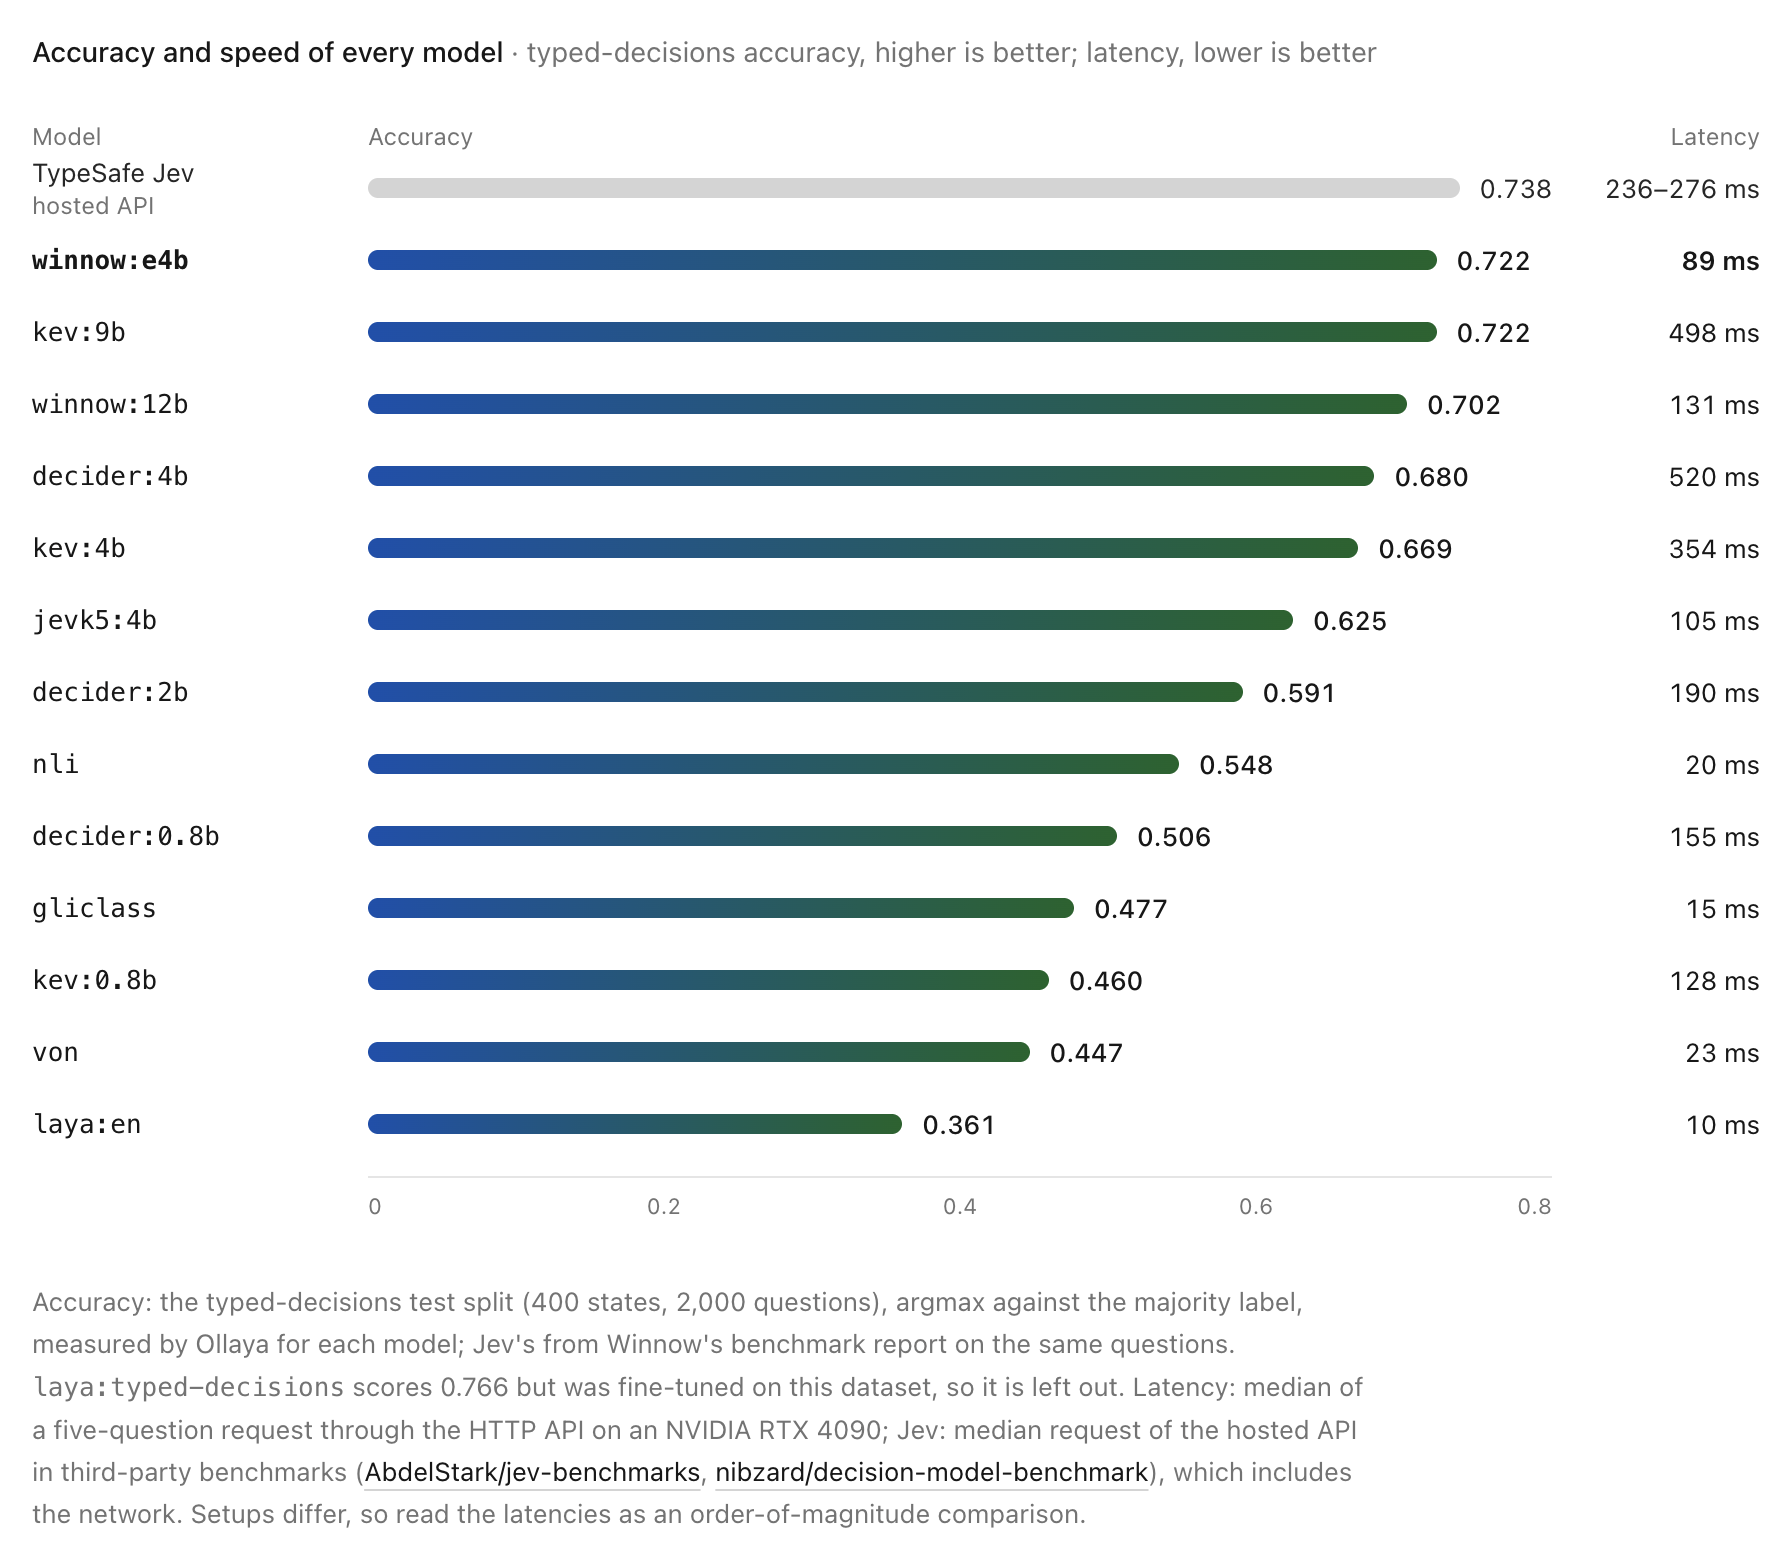
모델 선택이 중요합니다. Ollaya가 같은 시험 문제로 잰 표를 보면 권장 모델 winnow:e4b가 정확도 0.722로 Jev(0.738)에 가장 가깝고, RTX 4090에서 질문 다섯 개를 89ms에 답했습니다. 반면 가장 빠른 laya:en은 약 10ms지만 정확도가 0.361에 그쳤습니다.
| 모델 | 정확도(판정 시험) | 응답 속도 | 특징 |
|---|---|---|---|
| TypeSafe Jev(호스팅) | 0.738 | 236~276ms(네트워크 포함) | 비교 기준 |
| winnow:e4b | 0.722 | 89ms(RTX 4090) | 권장 모델, 약 8GB 다운로드 |
| kev:9b | 0.722 | 498ms | 큰 모델 |
| decider:4b | 0.680 | 520ms | 선택지 글자 확률 방식 |
| laya:en | 0.361 | 10ms | 가장 빠름, CPU에서도 가벼움 |
설치 환경도 확인해야 합니다. 맥은 애플 실리콘과 macOS 14 이상이 필요하고, 공식 표에서 애플 GPU(MLX) 가속이 명시된 건 laya와 nli 모델입니다. 속도는 엔비디아 GPU가 있는 윈도우·리눅스에서 가장 빠릅니다. 속도 수치는 측정 환경이 달라 "자릿수 비교" 정도로 보라고 Ollaya 스스로 밝히고 있습니다.
2. Laya: 설치형 판정 모델
Laya는 Convai Innovations가 공개한 판정 모델입니다. 파이썬 패키지로 설치해 코드에서 바로 부르거나, laya-serve로 Jev와 같은 형식의 서버를 띄울 수 있습니다. 가중치는 Apache 2.0으로 공개돼 있습니다.
pip install laya

from laya import Router
router = Router()   # 첫 사용 때 모델을 내려받음
result = router.predict(
    "결제가 두 번 됐어요. 오늘 안에 환불해 주세요.",
    {"team": {"type": "choice",
              "instructions": "Which team should handle this?",
              "criteria": {"billing": "payments, refunds",
                           "technical": "bugs, errors",
                           "other": "everything else"}}})
print(result["answers"]["team"]["choice"])
Laya 체크포인트는 영어용 laya, 100개 이상 언어용 laya-multilingual, 판정 업무 데이터로 추가 학습한 laya-typed-decisions 세 가지입니다. 공식 예제에서 Router는 입력 언어에 따라 영어 모델과 다국어 모델을 골라 씁니다.
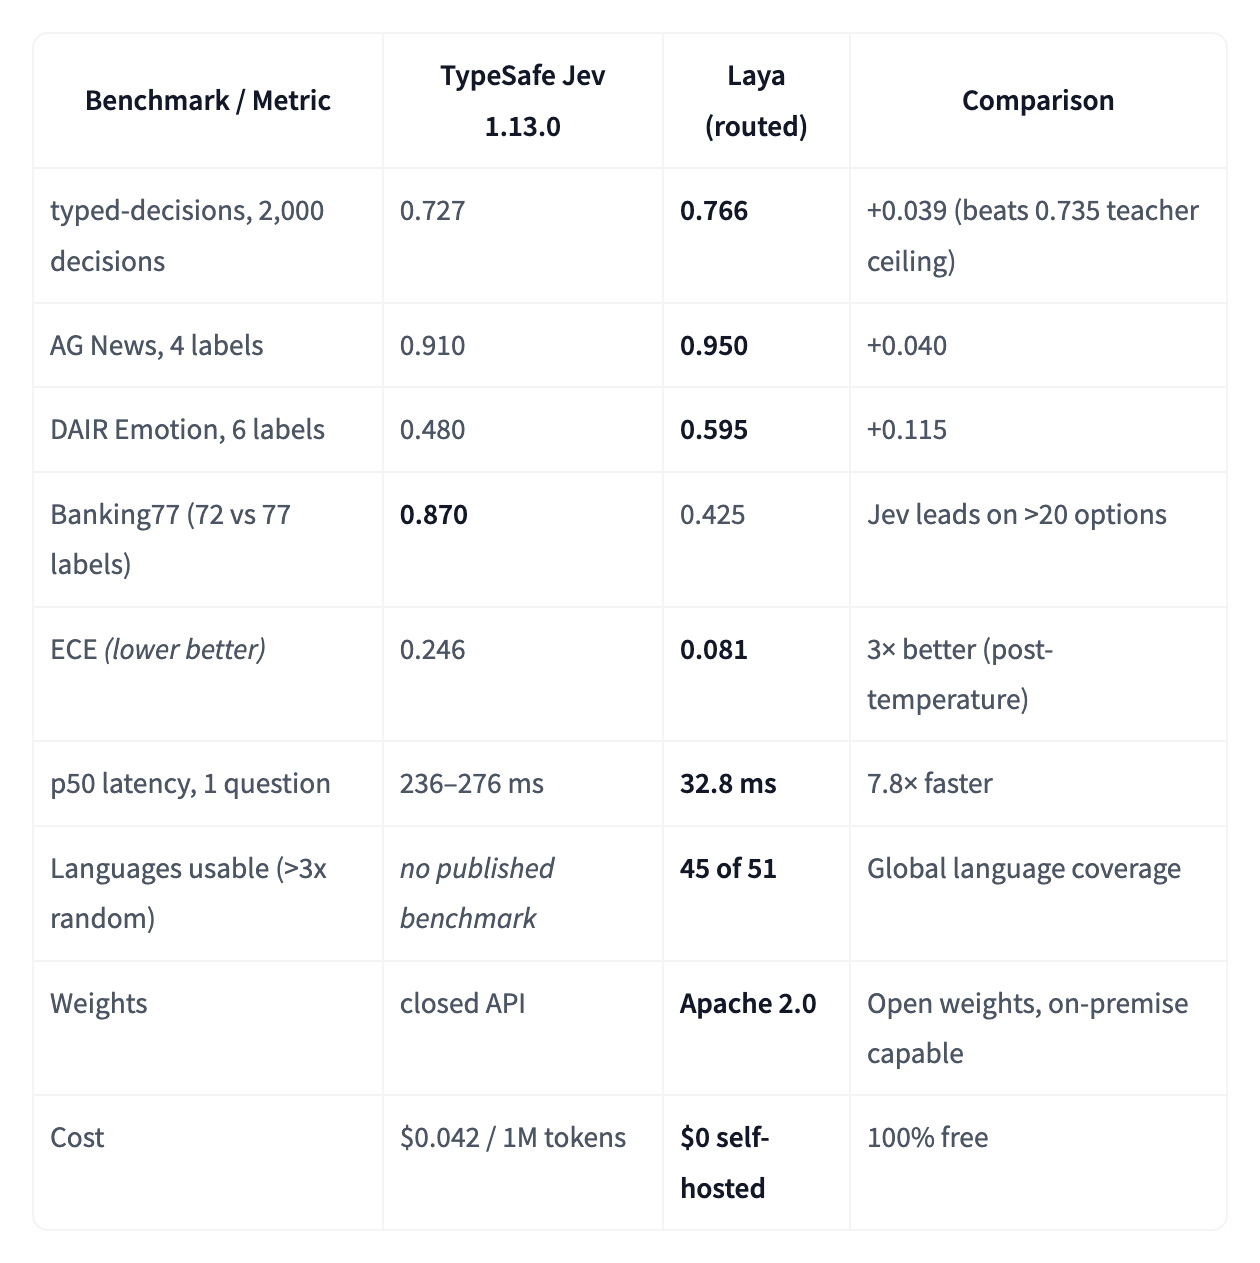
주의할 점은 모델 카드의 수치입니다. 업무 판정 2,000건으로 잰 시험에서 추가 학습한 laya-typed-decisions는 정확도 0.766이었지만, 추가 학습 없는 영어 기본 모델은 같은 문제에서 0.362였습니다. 모델 카드도 "정확도가 크게 오르는 건 내 분야 데이터로 파인튜닝할 때"라고 적었습니다. 그래서 제 판단으로는 Laya를 "바로 쓰는 판정 엔진"보다 "내 데이터로 다듬을 빠른 바탕"으로 보는 편이 맞습니다.
추가 학습 방법도 공개돼 있습니다. 캐글의 무료 T4 GPU 두 장으로 데이터셋 만들기, 학습, 확률 보정(온도 맞추기), 평가까지 한 번에 돌리는 공식 노트북이 있어, 정답이 달린 업무 예시만 있다면 시도해 볼 만합니다.
3. Privatemode Decisions: 일반 LLM을 판정 모델처럼
세 번째는 모델을 새로 만들지 않는 방법입니다. Privatemode Decisions는 GLM-5.3-Flash 같은 일반 LLM에 번호 매긴 선택지를 보여 주고, 답변 첫 글자를 번호 토큰으로만 제한한 뒤 그 확률을 읽어 선택지별 확률로 바꿉니다. 답이 한 토큰이라 빠르고, 비용은 거의 입력 토큰만 듭니다.
반응형
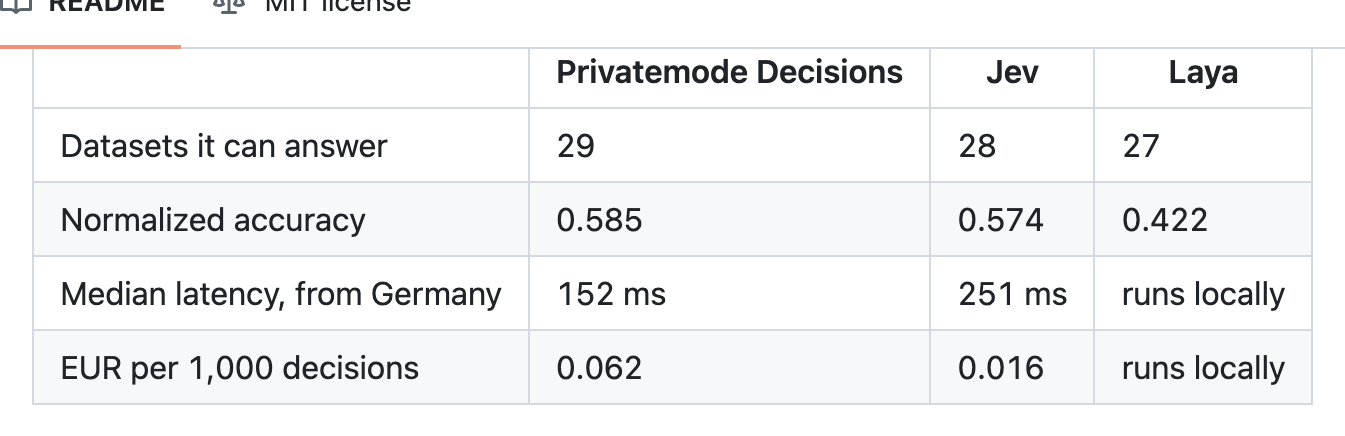
| 항목 | Privatemode Decisions | Jev | Laya |
|---|---|---|---|
| 답할 수 있는 데이터셋(29개 중) | 29 | 28 | 27 |
| 정규화 정확도 | 0.585 | 0.574 | 0.422 |
| 중간 응답 시간(독일 기준) | 152ms | 251ms | 로컬 실행 |
| 판정 1,000건 비용 | 0.062유로 | 0.016유로 | 로컬 실행 |
이 표는 Privatemode가 영어·독일어 공개 데이터셋 29개로 직접 잰 결과입니다. 둘 다 답할 수 있는 28개에서는 Jev와 통계적으로 구분되지 않았다고 밝혔습니다. 대신 이미지를 함께 넣을 수 있고, 한 질문에 선택지를 최대 191개까지 둘 수 있으며, 문맥은 최대 100만 토큰입니다.
비용과 조건도 봐야 합니다. 판정 1,000건 비용은 Jev보다 약 4배 비쌉니다. 기밀 처리(처리 중에도 데이터 암호화)를 받으려면 Privatemode API 키와 내 컴퓨터에서 도는 프록시가 필요합니다. vLLM 기반의 OpenAI 호환 서버라면 어디서나 쓸 수 있지만, 그때는 기밀성 보장이 빠집니다.
비슷한 요령을 이미지에 쓴 사례도 있습니다. 앞의 개발자는 Jev 요청 형식에 이미지 필드를 덧붙여, 웹캠 화면에 사람이 있는지·실내인지·얼마나 밝은지를 RTX 3090의 로컬 Gemma 4 12B로 초당 약 1장(한 장에 질문 3개) 판정했다고 공개했습니다.
PART 03
어떤 걸 골라야 하나
상황별 선택
| 이런 경우 | 추천 |
|---|---|
| Jev 코드가 있고 데이터를 밖에 못 보냄 | Ollaya + winnow:e4b(엔비디아 GPU 권장) |
| GPU 없이 가볍게 분류만 | Ollaya나 Laya의 작은 모델, 대신 내 데이터로 정확도 먼저 확인 |
| 내 업무 데이터로 학습시킬 수 있음 | Laya(공식 파인튜닝 노트북 제공) |
| 이미지 판정, 선택지가 많음 | Privatemode Decisions(유료) 또는 직접 LLM 확률 읽기 |
| 가입할 수 있고 외부 전송이 괜찮음 | Jev(설치 없이 저렴한 호스팅) |
제 판단으로는 "로컬이라 공짜"라는 말만 보고 고르면 실망하기 쉽습니다. 공개된 표만 봐도 추가 학습 없는 로컬 모델은 정확도가 0.36에서 0.72까지 벌어집니다. Laya처럼 그 시험에 맞춰 추가 학습하면 0.766까지 오르지만, 그만큼 내 데이터가 필요합니다. 어느 쪽이든 정답을 아는 내 예시 몇십 건으로 먼저 돌려 보고, 기준선을 정한 뒤에 쓰는 게 순서입니다.
한국어로 쓸 때
한국어 성능은 셋 모두 공식 수치가 부족합니다. Laya multilingual은 100개 이상 언어를 지원하고 51개 언어 가운데 45개에서 "찍기의 3배 이상" 성능을 냈다고 밝혔지만, 한국어만 따로 뗀 판정 정확도는 공개하지 않았습니다. Privatemode의 비교도 영어·독일어 데이터셋 기준입니다.
그래서 한국어 업무에 쓰려면 정답을 아는 한국어 예시로 직접 시험하는 과정이 필요합니다. 질문을 한국어로 쓸 때와 영어로 쓸 때를 나눠 돌려 보고 더 정확한 쪽을 고르는 방식을 권합니다. 로컬 모델일수록 이 확인 과정이 더 중요합니다.
Q. Ollaya에서 Jev 모델을 받을 수 있나요?
아닙니다. Jev는 TypeSafe가 호스팅으로만 제공하는 비공개 모델입니다. Ollaya는 Jev와 같은 API 형식을 흉내 낼 뿐, 실제로 돌리는 건 공개된 다른 판정 모델입니다.
Q. 로컬 모델은 정말 공짜인가요?
사용료는 없지만 하드웨어가 필요합니다. 권장 모델 winnow:e4b는 약 8GB를 내려받고 엔비디아 GPU에서 가장 빠릅니다. Ollaya 모델 설명에 따르면 CPU에서도 돌지만 24코어 CPU에서 질문 다섯 개에 약 5초가 걸려, CPU만 있다면 작은 모델이 현실적입니다. 작은 모델은 정확도를 먼저 확인해야 합니다.
다음 실험 예고
다음에는 같은 한국어 고객 문의 세 건을 Jev와 로컬 모델에 똑같이 넣어, 답과 확률이 얼마나 다른지 숫자로 비교해 보겠습니다. 로컬 판정 모델을 써 보려면 오늘은 Ollaya 홈페이지의 모델 표부터 보고 내 컴퓨터에서 돌릴 수 있는 모델을 골라 보세요.
728x90
반응형
'AI 이야기 > 이렇게 쓴다' 카테고리의 다른 글
| OpenAI dots 총정리 | 24시간 일하는 AI 직원, 한국에서 쓰는 조건과 맡기기 전 설정 (0) | 2026.09.30 |
|---|---|
| 클로드 코드 세션끼리 대화한다 | 다른 세션에 일을 넘기는 법과 코덱스·agy 비교 (0) | 2026.09.28 |
| Jev 사용법 총정리 | 글 대신 판정을 돌려주는 AI, 플레이그라운드부터 API까지 (0) | 2026.09.27 |
| Opus 5.5로 영상 만들기 | 편집 프로그램 없이 코드로 뽑는 원리와 실전 프롬프트 (0) | 2026.09.27 |
| Opus 5.5, 어디에 써야 본전 뽑나 | 스레드 사례로 본 활용법과 한도 아끼는 법 (0) | 2026.09.27 |


댓글 영역