고정 헤더 영역
상세 컨텐츠
본문
728x90
반응형
"74B짜리 AI 모델이 24GB에 들어간다"는 소식을 보면 내 24GB 노트북에서 돌아가겠다는 생각이 먼저 듭니다. 그런데 24GB는 노트북 사양이 아니라 모델 자체의 크기입니다. 엔비디아가 10월 15일 공개하는 네모트론 3.5 볼트(영문명 Nemotron 3.5 Bolt)를 읽을 때 가장 먼저 바로잡을 부분입니다.
모델이 풀리는 날이 10월 15일이라 성능표와 정확한 다운로드 이름은 아직 없습니다. 그래서 엔비디아가 밝힌 사실, 어려운 용어 풀이, 필요한 메모리 감각, 공개 당일 확인할 항목 순서로 정리했습니다.
한 줄 요약: 엔비디아는 오픈소스 모델 Nemotron 3.5 Bolt 74B-A9B를 10월 15일 공개한다. 전체 74B 중 토큰당 9B만 쓰는 MoE 구조이고, 2비트 양자화로 모델 크기를 24GB까지 줄였다. 24GB는 모델 크기이며, 엔비디아는 이 모델을 최대 128GB 통합 메모리의 RTX Spark 노트북(10월 16일 출시)용으로 소개했다.
1. 엔비디아가 발표한 것만 정리하면
이름의 "볼트"는 영어로 Bolt입니다. 공식 이름은 NVIDIA Nemotron 3.5 Bolt 74B-A9B 24GB이고, 엔비디아는 이 모델을 RTX Spark에서 로컬 에이전트를 돌리기 위해 만든 LLM이라고 소개했습니다. 이름 끝의 "74B-A9B"는 전체 74B(740억) 파라미터 중 9B(90억)가 활성이라는 표기입니다.
| 항목 | 엔비디아 발표 내용 |
|---|---|
| 공개일 | 10월 15일(목) |
| 구조 | MoE(전문가 혼합), 전체 74B·토큰당 활성 9B |
| 크기 | 2비트 양자화와 양자화 인식 학습으로 24GB에 담음 |
| 실행 도구 | 공개 당일 llama.cpp, vLLM, Ollama, Unsloth, LM Studio |
| 에이전트 연결 | Hermes, OpenClaw에서 바로 접근 |
| 오픈소스 범위 | 학습 데이터, 가중치, 레시피 모두 공개(파인튜닝 가능) |
| 대상 기기 | RTX Spark 노트북(10월 16일 출시, 통합 메모리 최대 128GB) |
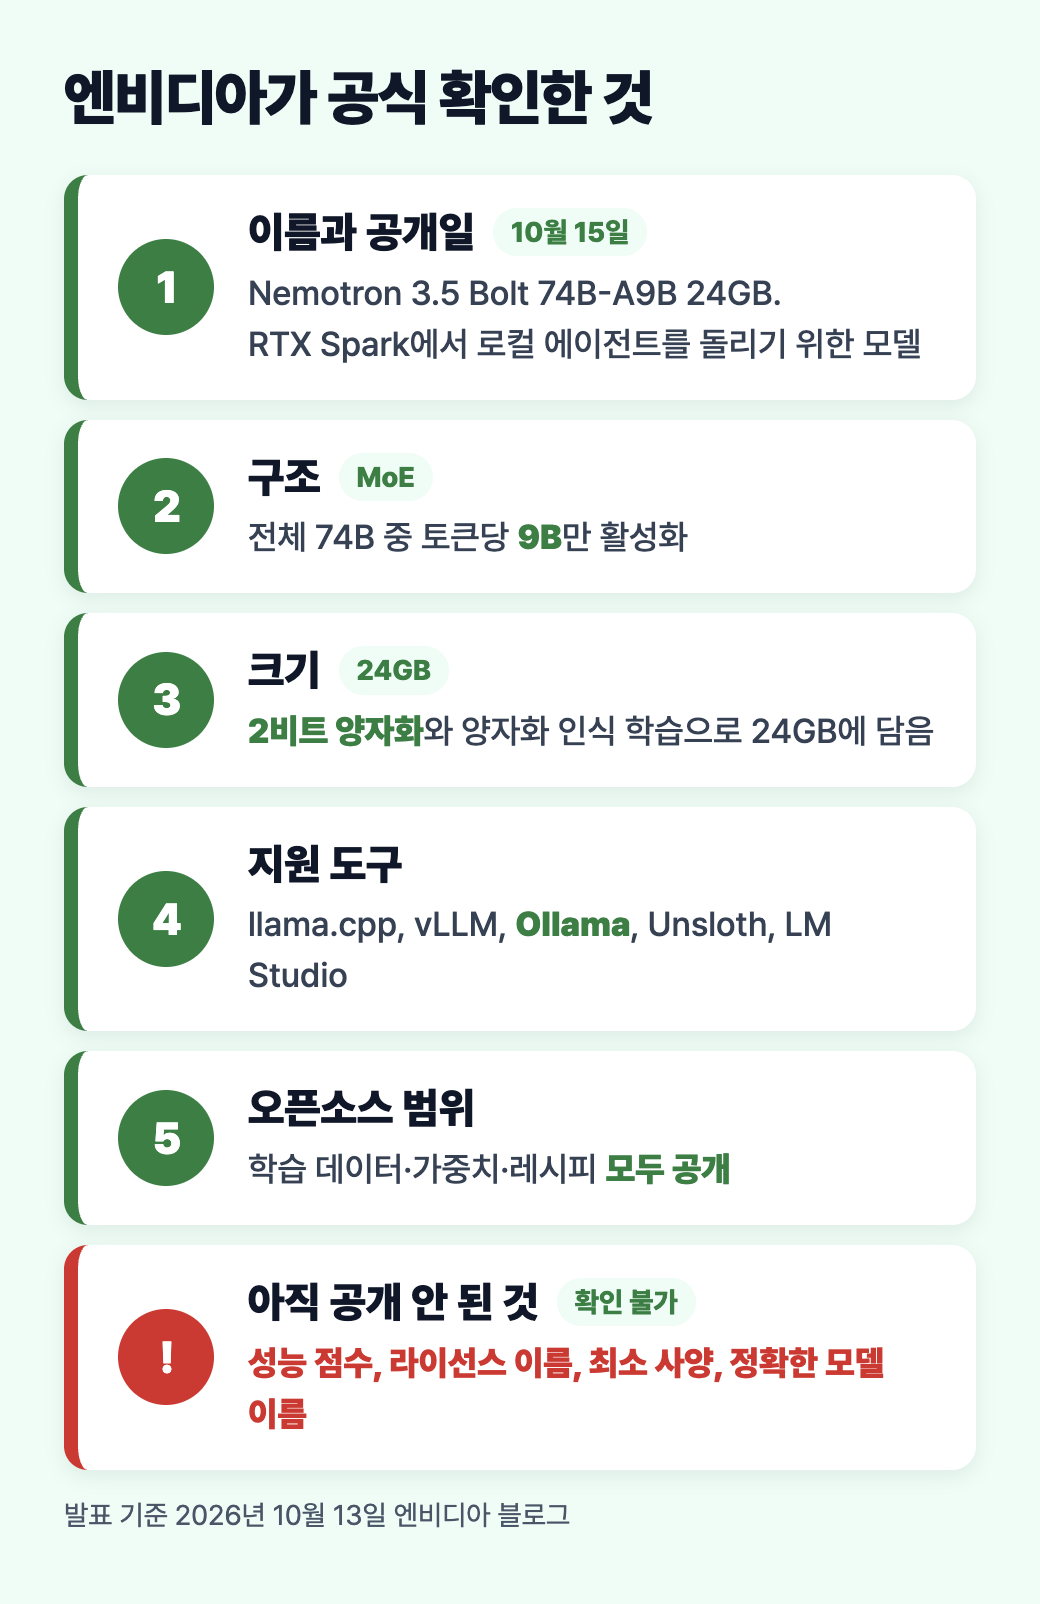

주의 엔비디아는 이 모델이 대표적인 dense 모델보다 빠르고 메모리 크기가 비슷한 대표적인 MoE 모델보다 똑똑한 균형을 목표로 한다고 설명했을 뿐, 비교 대상과 점수는 밝히지 않았습니다. 라이선스 이름, 최소 사양, 정확한 모델 이름도 공개 전이라 아직 없습니다. 달성했다는 뜻이 아니라 엔비디아의 목표 설명으로 읽어 두세요.
2. MoE: 74B인데 왜 9B만 일하나
MoE(Mixture of Experts, 전문가 혼합)는 모델 안에 "전문가" 덩어리를 여러 개 두고, 단어(토큰) 하나를 처리할 때 그중 일부만 골라 계산하는 구조입니다. 대형 병원에 전문의가 많아도 환자 한 명에게는 필요한 몇 명만 붙는 것과 비슷합니다. 볼트는 전체 74B 중 9B만 한 번에 쓰므로, 같은 크기의 일반(dense) 모델보다 계산이 가볍습니다.
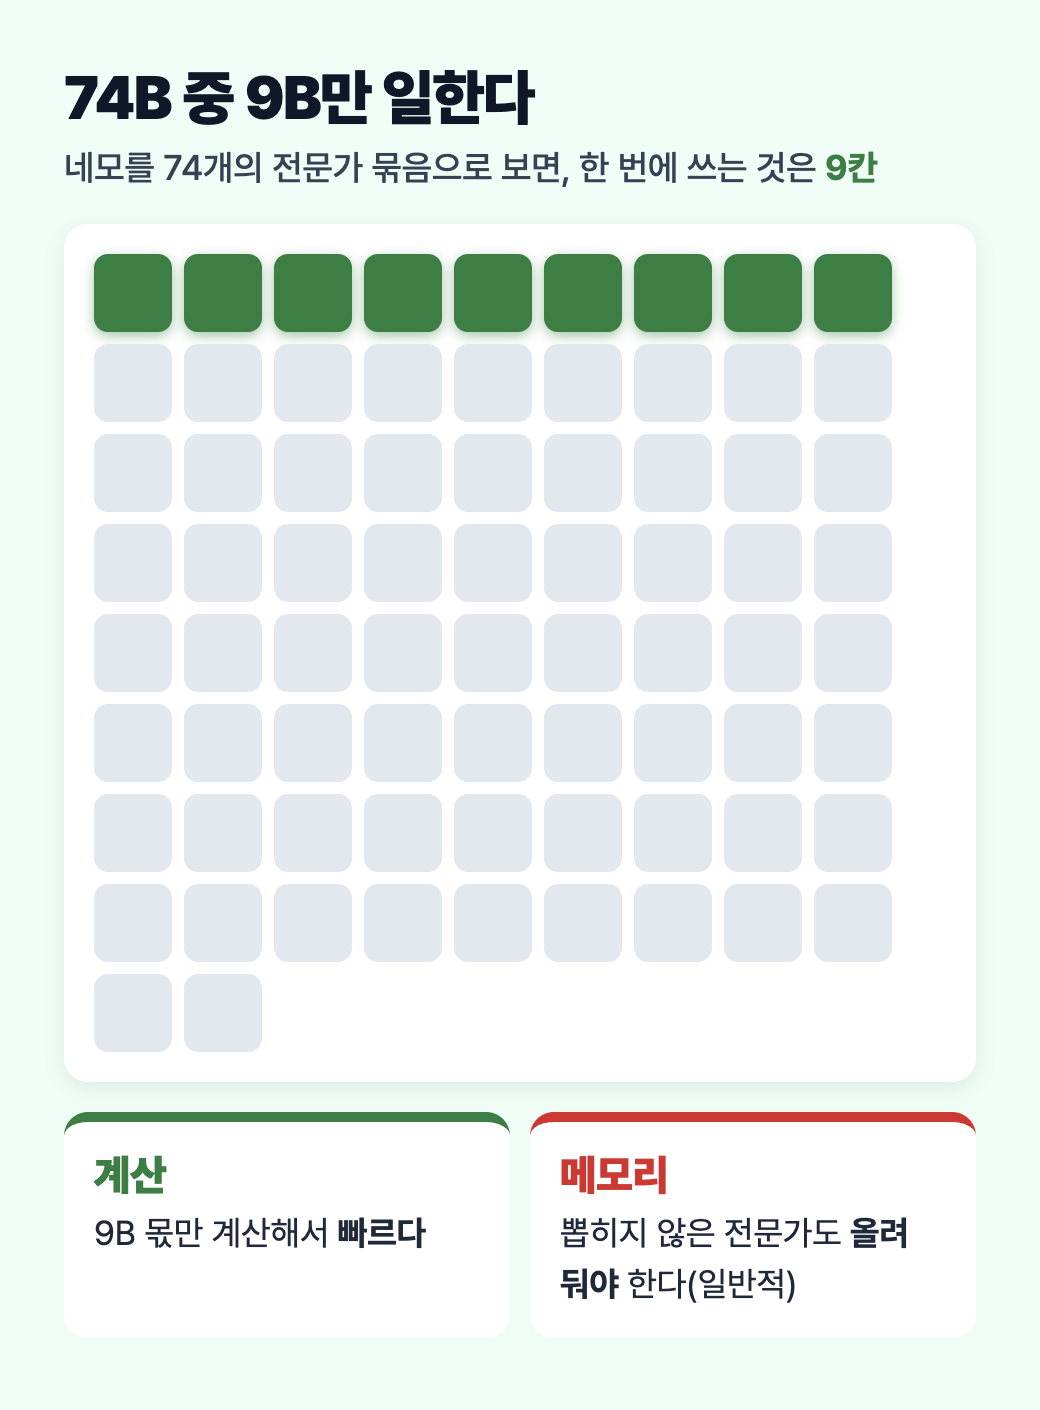
다만 어느 전문가가 뽑힐지 미리 알 수 없어서, 일반적으로는 쓰지 않는 전문가까지 전체 가중치를 메모리에 올려 두어야 합니다. 활성 파라미터 9B는 "빨리 답한다"에 가깝고, 메모리에는 74B 몫이 필요합니다. 그래서 74B를 24GB까지 줄인 압축이 이 모델의 핵심이 됩니다.
3. 2비트 양자화: 어떻게 24GB가 되고 품질은 괜찮은가
양자화는 모델의 숫자(가중치)를 더 적은 비트로 저장해 크기를 줄이는 방법입니다. 순수하게 비트 수만 계산하면 74B 파라미터를 16비트로 저장할 때 약 148GB, 8비트 약 74GB, 4비트 약 37GB, 2비트 약 18.5GB입니다. 이 숫자는 필자의 단순 계산이고, 실제 파일에는 부가 정보가 더해집니다.
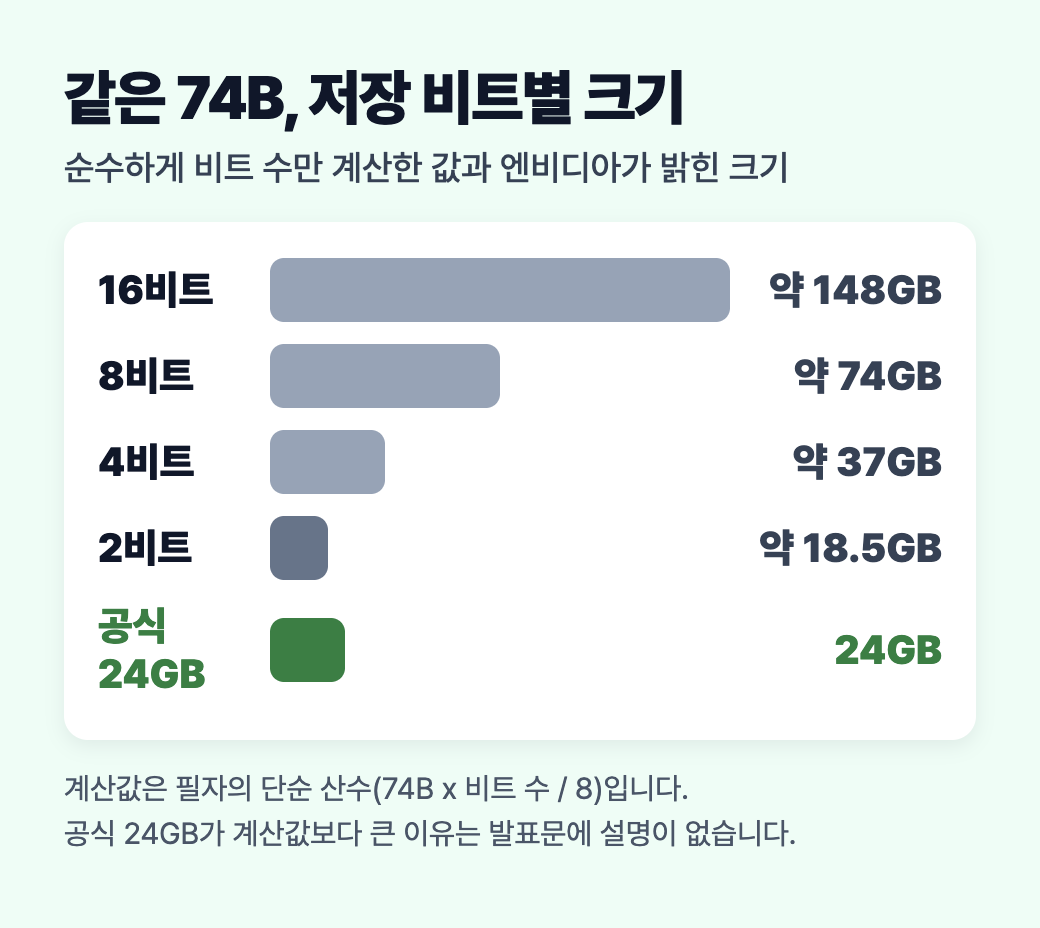
엔비디아가 밝힌 크기는 계산값보다 큰 24GB입니다. 이유는 발표문에 설명이 없습니다. 엔비디아는 다른 Nemotron 모델의 양자화 설명에서 층마다 양자화에 민감한 정도가 달라 일부 층은 더 높은 정밀도로 남긴다고 밝힌 적이 있는데, 볼트가 그렇게 만들어졌는지는 확인되지 않았습니다.
품질은 어떻게 지킬까요. 엔비디아는 볼트에 양자화 인식 학습(QAT)을 썼다고 했습니다. 엔비디아 기술 블로그는 QAT를 사전 학습 뒤 추가 학습 단계에서 모델이 낮은 정밀도 계산에 적응하도록 가르치는 방법이라고 설명합니다. 이미 완성된 모델을 학습 없이 줄이는 방식보다 정확도 회복에 유리하다는 설명입니다.
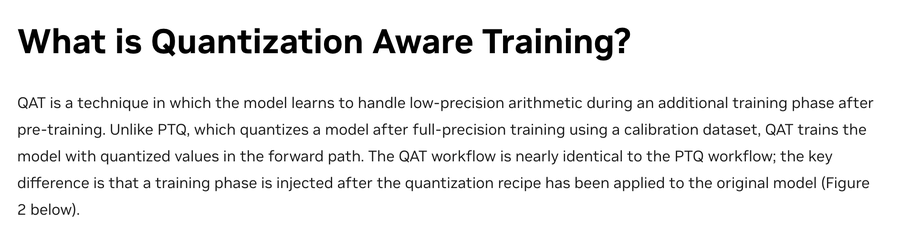
주의 이 설명은 QAT 일반론입니다. 볼트에서 품질이 실제로 얼마나 유지되는지는 엔비디아가 수치를 내놓지 않았습니다. 2비트는 아주 공격적인 압축이라, 독립 평가가 나오기 전에는 "유지됐다"고 단정하지 않는 편이 안전합니다.
4. 24GB의 진짜 의미: 어떤 노트북이 필요한가
엔비디아가 밝힌 모델 크기가 24GB라는 뜻입니다. 실제 다운로드 용량은 공개 후 모델 카드에서 확인해야 하고, 돌릴 때는 여기에 운영체제와 앱이 쓰는 메모리, 긴 대화를 기억하는 작업 메모리(KV 캐시)가 더해집니다. 엔비디아는 최소 사양을 밝히지 않았지만, 제 판단으로는 메모리가 24GB 안팎인 노트북은 모델만으로 가득 차서 빠듯하거나 안 될 가능성이 큽니다.
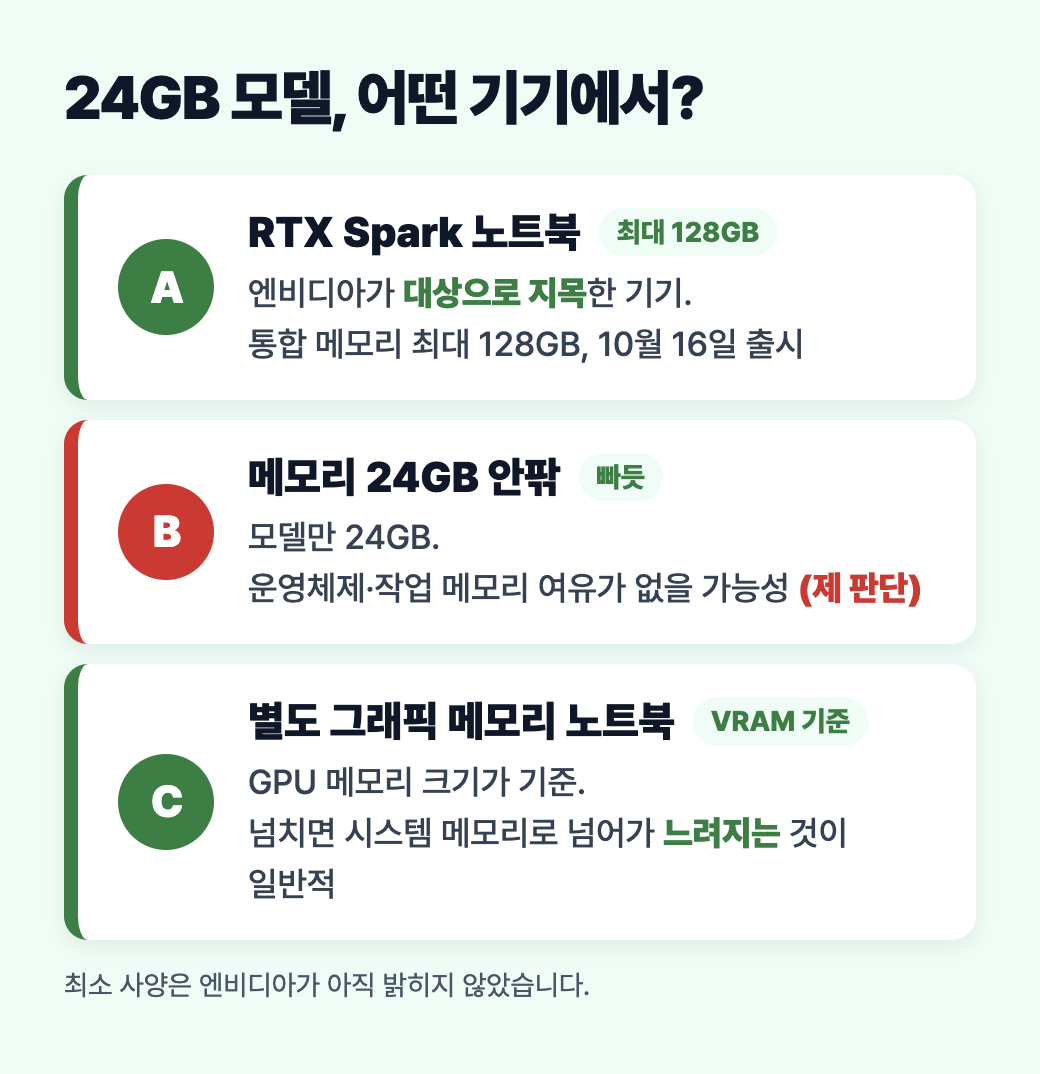
| 기기 구성 | 엔비디아 공식 설명 | 제 판단 |
|---|---|---|
| RTX Spark 노트북 | 통합 메모리 최대 128GB, 최대 120B 파라미터 모델 실행, 10월 16일 출시 | 엔비디아가 이 모델의 대상으로 지목한 기기 |
| 메모리 24GB 안팎 노트북 | 언급 없음(최소 사양 미공개) | 모델만 24GB라 운영체제·작업 메모리 여유가 없어 빠듯할 가능성 |
| 별도 그래픽 메모리 노트북 | 언급 없음 | GPU 메모리 크기가 기준이고, 넘치면 시스템 메모리로 넘어가 느려지는 것이 일반적 |
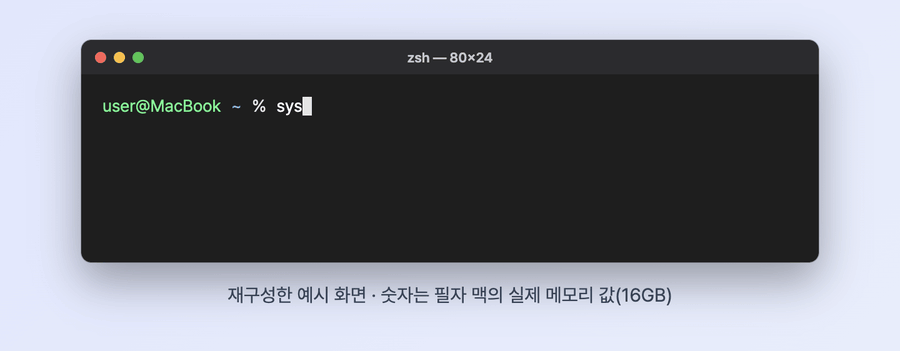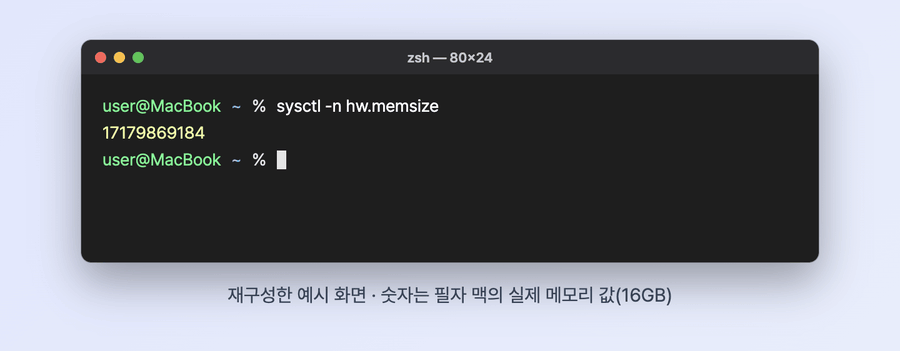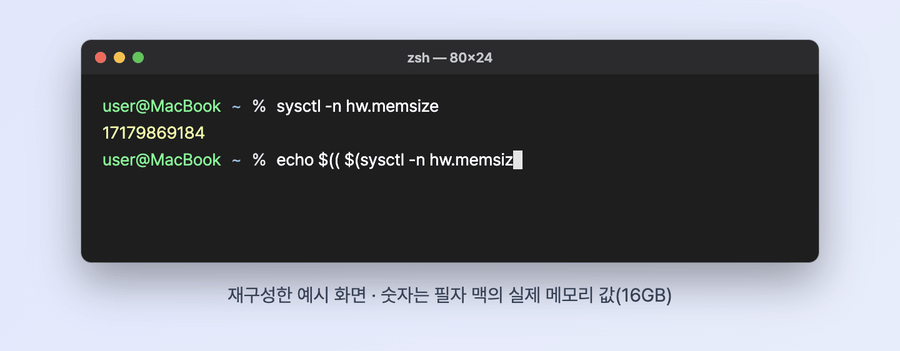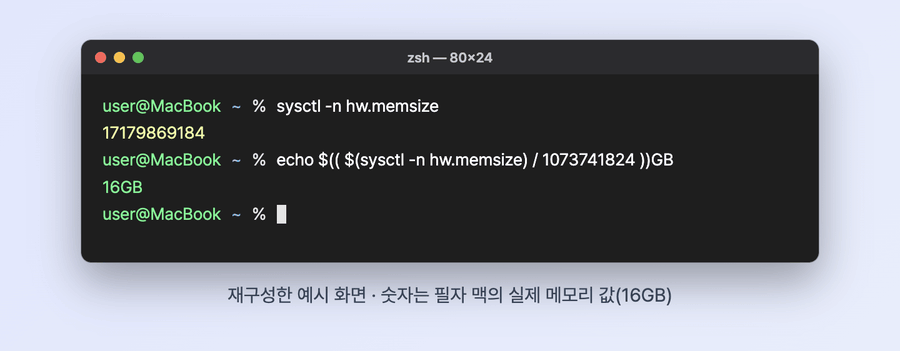
내 노트북 메모리는 터미널 한 줄로 확인할 수 있습니다. 맥에서는 아래 명령이 메모리 크기를 바이트 단위로 알려 주고, 1073741824(2의 30제곱)로 나누면 맥이 말하는 GB(정확히는 GiB)가 됩니다. 메모리를 더 늘릴 수 없는 노트북이 많으니, 구매 전에 이 숫자가 중요합니다.
메모리를 기준으로 PC를 고르는 방법은 로컬 AI PC 사양, 그래픽카드보다 먼저 볼 것에 정리해 두었습니다.
5. 로컬 에이전트는 클라우드와 무엇이 다른가
엔비디아는 RTX Spark 소개 페이지에서 로컬로 돌리면 "구독이나 요청당 요금이 없고 데이터가 내 기기에 남는다"고 설명합니다. 에이전트가 내 파일과 일정에 접근하는 일이 많으니, 이 두 가지가 로컬의 가장 큰 장점으로 꼽힙니다. 같은 발표에서 엔비디아는 Qwen 3.8-Flash-Next 같은 로컬 모델이 몇 달 전 나온 클라우드 최상위 모델을 따라잡았다고 설명했는데, 볼트의 성능을 뜻하는 말은 아닙니다.
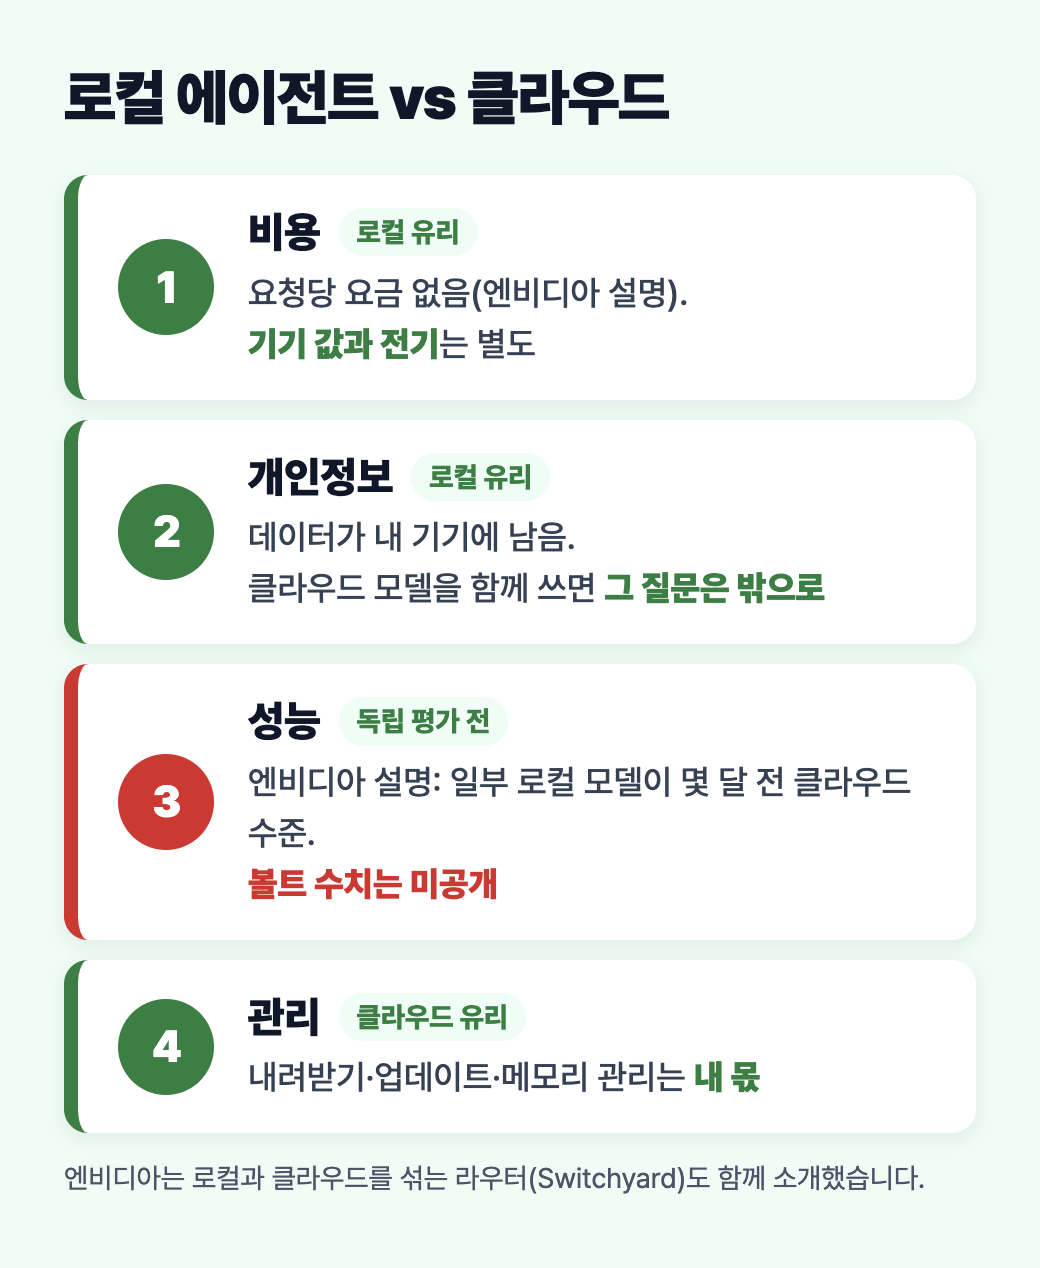
| 비교 | 로컬(내 기기) | 클라우드 |
|---|---|---|
| 비용 | 요청당 요금 없음(엔비디아 설명). 기기 값과 전기는 별도 | 사용량·구독에 따라 과금 |
| 개인정보 | 데이터가 내 기기에 남음. 클라우드 모델을 함께 쓰도록 설정하면 그 질문은 밖으로 나감 | 회사 서버로 전송 |
| 성능 | 엔비디아 설명: 일부 로컬 모델이 몇 달 전 클라우드 수준. 볼트는 독립 평가 전 | 최신 최상위 모델 사용 가능 |
| 관리 | 모델 내려받기·업데이트·메모리 관리는 내 몫 | 회사가 관리 |
로컬과 클라우드를 섞어 쓰는 방식도 엔비디아가 함께 내놓았습니다. Switchyard라는 오픈소스 라우터가 질문마다 로컬 모델과 클라우드 모델 중 하나를 고르게 하는데, Hermes에는 10월 중 추가된다고 합니다. 그래서 "전부 로컬" 아니면 "전부 클라우드"로 나눌 필요는 없습니다. 비슷한 개념은 온디바이스 AI란? 내 폰 안에서 도는 AI 쉽게 이해하기에서 폰 기준으로 설명했습니다.
6. 공개 당일, Ollama로 이렇게 확인하세요
엔비디아는 볼트를 공개 당일 Ollama에서도 돌릴 수 있다고 밝혔지만, 모델 이름(태그)은 공개 전이라 알 수 없습니다. 같은 계열 모델 선례를 보면 Ollama는 모델 이름만 붙여 실행하는 형식입니다. Ollama 블로그는 Nemotron 3.5 Lightning을 ollama run nemotron-3.5-lightning 한 줄로 실행하도록 안내했습니다. 볼트도 같은 형식이 될 가능성이 크지만, 정확한 이름은 ollama.com의 모델 목록에서 확인해야 합니다.
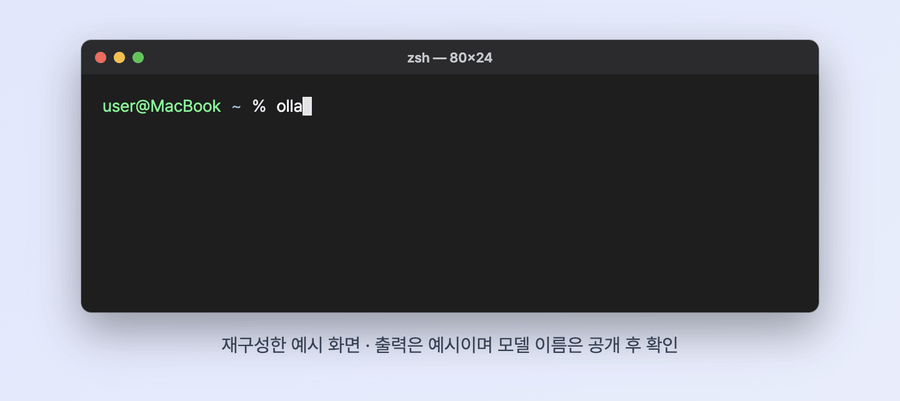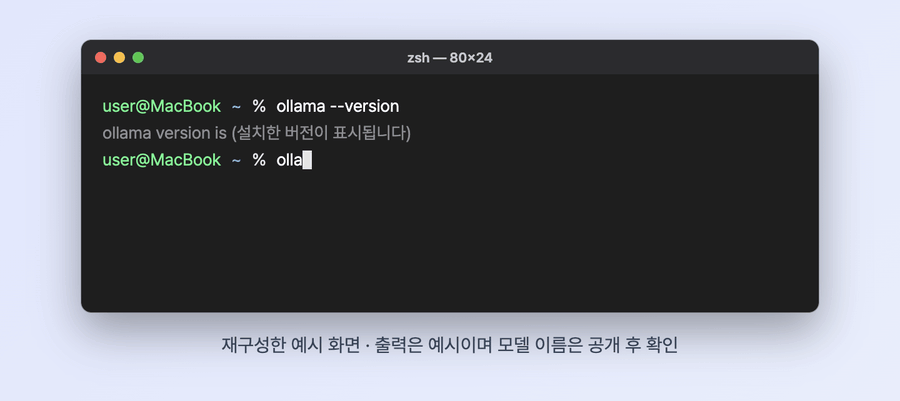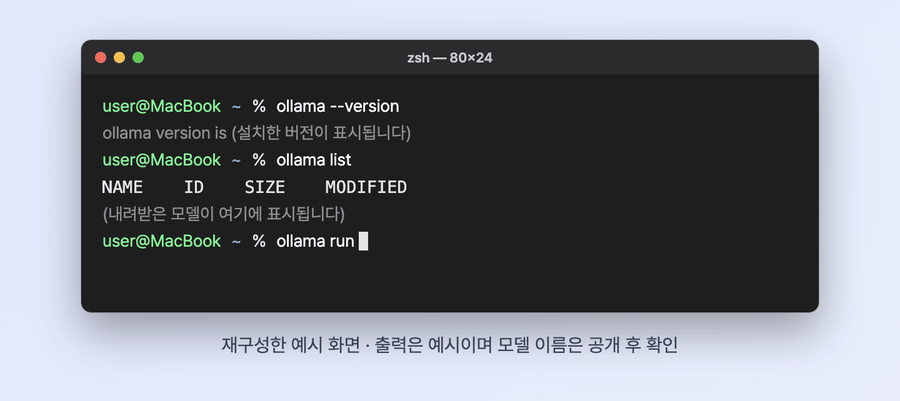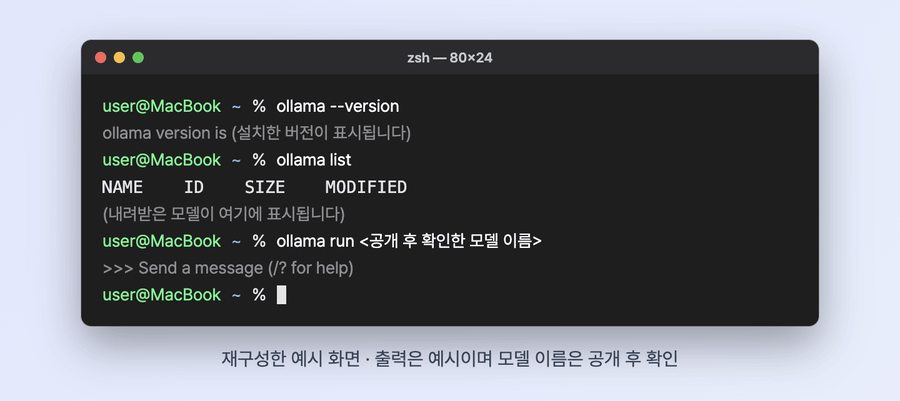
핵심 공개 당일 체크리스트 1) ollama.com의 모델 목록에서 nemotron을 검색해 볼트 이름과 용량 확인 2) 모델 카드에서 라이선스(상업 이용 가능 여부)와 권장 메모리 확인 3) 모델 카드의 실제 다운로드 용량과 필요한 디스크·메모리 여유 확인 4) 엔비디아가 밝히지 않았던 성능 수치가 공개됐는지 확인 5) 내려받기 전 내 노트북 메모리 숫자 다시 보기
주의 이 글에서 본 설치 명령은 모두 예시입니다. 공개 전이라 실제 실행 출력은 없습니다. 모델 이름이 확인된 뒤 공식 안내를 그대로 따르세요.
3줄 선택 가이드 RTX Spark 노트북을 살 계획이라면 공개 당일 모델 카드와 독립 평가가 나오는 것을 보고 판단해도 늦지 않습니다. 메모리 24GB 안팎 노트북이라면 볼트를 기대하기보다 4GB급 소형 모델부터 알아보는 쪽이 현실적입니다(제 판단). 개발자라면 공개 당일 내려받아 내 작업에서 직접 비교해 보세요. 점수보다 내 작업에서의 체감이 결정적입니다.
Q. 볼트인가요, 볼트(Volt)인가요?
공식 이름은 영어 Bolt입니다. 엔비디아는 Nemotron 3.5 Bolt 74B-A9B 24GB라고 불렀습니다. 한글로는 볼트로 읽습니다.
Q. 24GB 노트북에서 돌아가나요?
엔비디아는 최소 사양을 밝히지 않았습니다. 엔비디아가 밝힌 모델 크기가 24GB라서 운영체제와 작업 메모리까지 생각하면 24GB 안팎 기기는 빠듯하거나 어려울 가능성이 크다는 것이 제 판단입니다. 공개 후 모델 카드와 실제 사용 후기를 확인하세요.
Q. 무료로 써도 되나요?
엔비디아는 학습 데이터, 가중치, 레시피까지 오픈소스로 공개한다고 밝혔습니다. 상업 이용 같은 라이선스 조건은 발표문에 나오지 않았으니 모델 카드의 라이선스를 직접 확인하세요.
Q. 2비트로 줄이면 많이 멍청해지지 않나요?
엔비디아는 양자화 인식 학습으로 품질을 유지하려 했다고 설명하지만 수치는 아직 없습니다. 독립 평가가 나오기 전까지는 판단을 미루는 편이 맞습니다.
Q. 같이 나온 4GB짜리 볼트는 무엇인가요?
Nemotron 3.5 Bolt E4B 4GB는 10월 23일 공개 예정인 소형 모델로, 엔비디아는 게임 속 AI 캐릭터와 음성·기기 도우미용이라고 소개했습니다. 74B 모델과는 용도가 다른 별개 모델입니다.
3줄 핵심 요약
- 엔비디아 네모트론 3.5 볼트 74B-A9B는 10월 15일 공개되는 완전 오픈소스 MoE 모델이다. 전체 74B 중 9B만 쓰고 2비트 양자화로 24GB까지 줄였다.
- 24GB는 모델 크기이지 노트북 사양이 아니다. 엔비디아는 최대 128GB 통합 메모리의 RTX Spark를 대상으로 소개했고, 최소 사양과 성능 수치는 아직 공개되지 않았다.
- 공개 당일 Ollama 모델 이름, 모델 카드의 라이선스와 권장 메모리, 독립 평가를 확인하고, 그 전에 내 노트북 메모리부터 확인하자.
마치며
오늘 할 일은 하나입니다. 터미널에서 내 노트북 메모리를 확인하는 한 줄을 실행해 보세요. 그 숫자가 24GB보다 한참 크다면 공개 당일 볼트를 시험해 볼 만하고, 24GB 안팎이라면 모델 카드의 권장 메모리가 나올 때까지 기다리는 편이 낫습니다.
NEXT READ
이어서 읽어 볼 글
01 로컬 AI PC 사양, 그래픽카드보다 먼저 볼 것 · 로컬 모델을 돌릴 PC를 고를 때 먼저 볼 것
02 온디바이스 AI란? 내 폰 안에서 도는 AI 쉽게 이해하기 · 내 기기 안에서 도는 AI의 기본 개념
#네모트론3.5볼트,#NemotronBolt,#엔비디아,#로컬AI,#RTXSpark,#오픈소스LLM,#MoE,#양자화,#Ollama,#이렇게쓴다
728x90
반응형


댓글 영역