고정 헤더 영역

상세 컨텐츠
본문
728x90
반응형
Jev를 쓰면서 "이 판정, 내 서버에서 돌릴 수는 없나" 생각해 본 적이 있다면 반가운 소식입니다. Cloudflare가 10월 1일 판정 전용 AI 모델 Clef와 Clef-flash를 내놓으면서 가중치까지 Apache 2.0으로 풀었습니다. 호출 형식은 Jev와 같고, 글자뿐 아니라 이미지도 판정합니다.
다만 "Jev보다 낫다"는 성적표는 Cloudflare가 직접 잰 숫자입니다. 어떤 항목에서 이겼고 어디서 졌는지, 실제로 얼마를 내고 몇 줄로 부를 수 있는지, 오픈AI가 같은 주에 꺼낸 Decisions API와는 무엇이 다른지 공식 문서를 기준으로 짚었습니다.
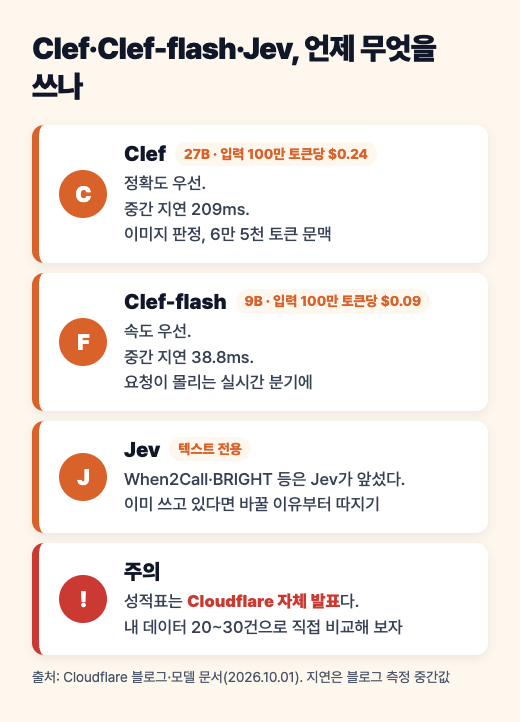
Clef와 Clef-flash는 Cloudflare가 2026년 10월 1일 공개한 판정(decision) 모델이다. 상태와 질문 목록을 넣으면 글을 쓰는 대신 정해 둔 보기마다 확률을 돌려준다. Clef는 270억(27B), Clef-flash는 90억(9B) 파라미터이고, 둘 다 문맥 65,536토큰과 이미지 입력을 지원한다. Workers AI 가격은 입력 100만 토큰당 Clef 0.24달러, Clef-flash 0.09달러이며, 하루 10,000 Neurons 무료 할당량 안에서 시험할 수 있다. 가중치는 허깅페이스에 Apache 2.0으로 공개됐다. Cloudflare 자체 측정으로 중간 지연은 Clef 209ms, Clef-flash 38.8ms, Jev 524ms였고, When2Call·BRIGHT 같은 일부 항목은 Jev가 앞섰다.
1. Clef가 뭐길래: 글 대신 확률을 돌려주는 AI
판정 모델은 "급한 문의인가요?", "어느 팀이 맡아야 하나요?" 같은 질문에 문장으로 답하지 않습니다. 미리 정해 둔 보기마다 확률을 매겨 돌려주고, 그 숫자를 보고 다음 행동을 고르는 건 내 코드입니다. 에이전트가 일을 넘길지, 사람에게 물을지 정하는 갈림길에 꽂아 쓰는 부품이라고 보면 됩니다.
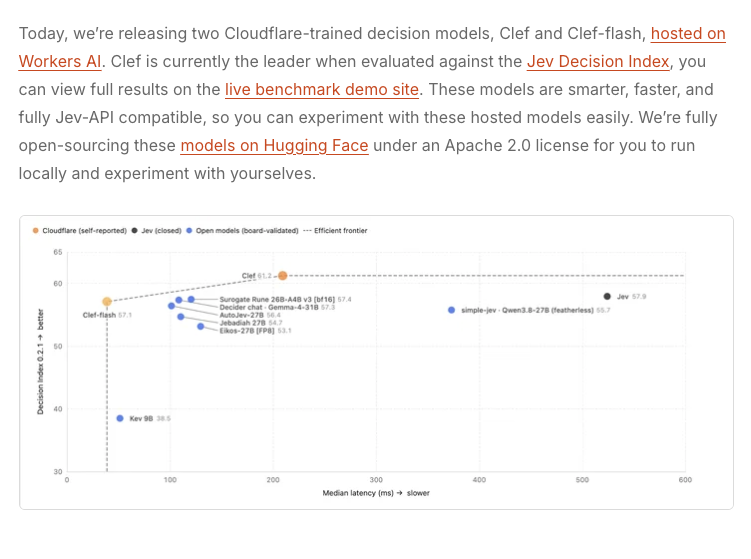
Cloudflare 블로그는 Clef를 Jev가 띄운 "판정 모델" 흐름 위에 놓으면서도 차이를 세 가지로 꼽았습니다. 이미지를 읽는 비전 인코더가 있고, 문맥이 64k로 Jev(32k)의 두 배이며, 가중치를 허깅페이스에 Apache 2.0으로 공개했다는 점입니다. Jev 자체가 처음이라면 Jev 사용법 글을 먼저 보고 오면 이 글이 더 잘 읽힙니다.
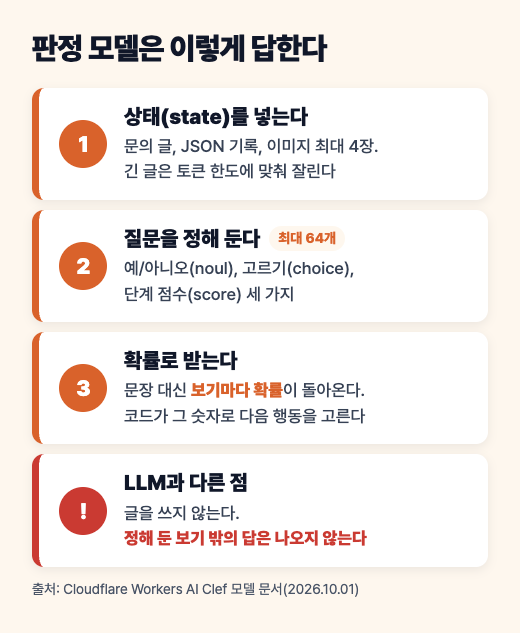
핵심 판정 모델은 정해 둔 보기 밖의 답을 하지 않습니다. 그래서 결과를 코드로 다루기 쉽지만, 질문과 보기를 잘못 짜면 그럴듯한 확률이 붙은 엉뚱한 판정이 나옵니다.
2. 얼마나 내나: Workers AI 가격과 무료 할당량
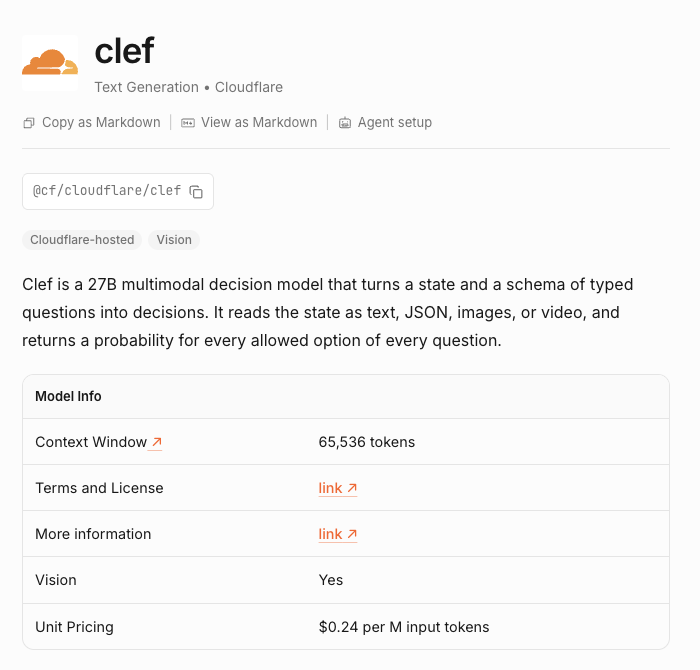
| 항목 | Clef | Clef-flash |
|---|---|---|
| 크기 | 27B | 9B |
| 모델 ID | @cf/cloudflare/clef | @cf/cloudflare/clef-flash |
| 문맥 | 65,536토큰 | 65,536토큰 |
| 이미지 입력 | 가능(최대 4장) | 가능(최대 4장) |
| 가격(입력 100만 토큰당) | 0.24달러 | 0.09달러 |
| 무료 할당량으로 하루 처리량(환산) | 약 45만 토큰 | 약 122만 토큰 |
Workers AI 가격표에 따르면 무료·유료 플랜 모두 하루 10,000 Neurons를 무료로 씁니다. Clef는 입력 100만 토큰이 21,818 Neurons, Clef-flash는 8,182 Neurons로 잡혀 있어, 무료 할당량만으로도 짧은 문의 글로 꽤 여러 번 시험해 볼 수 있습니다. 위 표의 하루 처리량은 이 숫자로 제가 나눠 본 환산값이고, 실제 처리 건수는 글 길이와 질문 수에 따라 달라집니다.
출력 토큰 요금은 따로 적혀 있지 않습니다. 판정 모델은 문장을 생성하지 않기 때문입니다. 무료 할당량을 넘기면 Workers 유료 플랜이 필요하고, 1,000 Neurons당 0.011달러가 붙습니다.
3. curl 한 번으로 불러 보기
필요한 것은 Cloudflare 계정 ID와 Workers AI 권한이 있는 API 토큰 두 가지입니다. 아래는 Clef-flash 모델 문서의 예시를 한국어 문의로 바꾼 것입니다. 질문 종류는 예/아니오(noul), 고르기(choice), 단계 점수(score) 세 가지이고, 한 번에 최대 64개까지 넣을 수 있습니다.
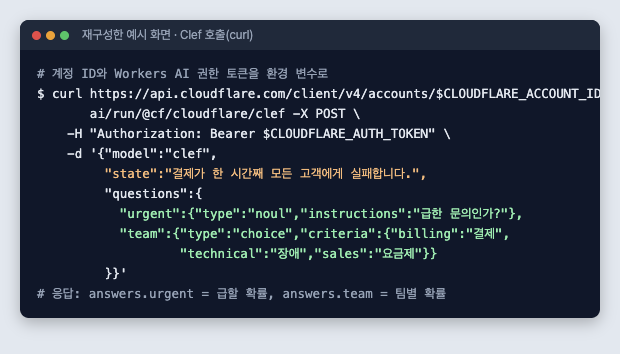
응답의 answers 안에 질문 이름 그대로 결과가 담깁니다. urgent에는 급할 확률이, team에는 고른 팀과 팀별 확률이, severity에는 확률을 가중한 점수가 들어옵니다. 저는 이번에 인증된 계정으로 직접 호출해 보지는 못했으니, 한국어 문의를 넣을 계획이라면 실제 응답부터 확인해 보세요.
주의 이미지는 요청 본문에 직접 담아 보내야 하고 원격 URL은 받지 않습니다. 이미지당 4MiB, 전체 요청은 13MiB까지라 스크린샷을 그대로 올리면 금방 한도에 닿습니다.
4. Jev와 비교: 어디서 이기고 어디서 졌나
Cloudflare는 Jev 판정 지수(Jev Decision Index)의 평가 항목으로 여러 판정 모델을 함께 쟀습니다. 결과만 보면 Clef 쪽이 많이 이깁니다. 하지만 Jev가 앞선 항목도 블로그 표에 그대로 남아 있습니다.
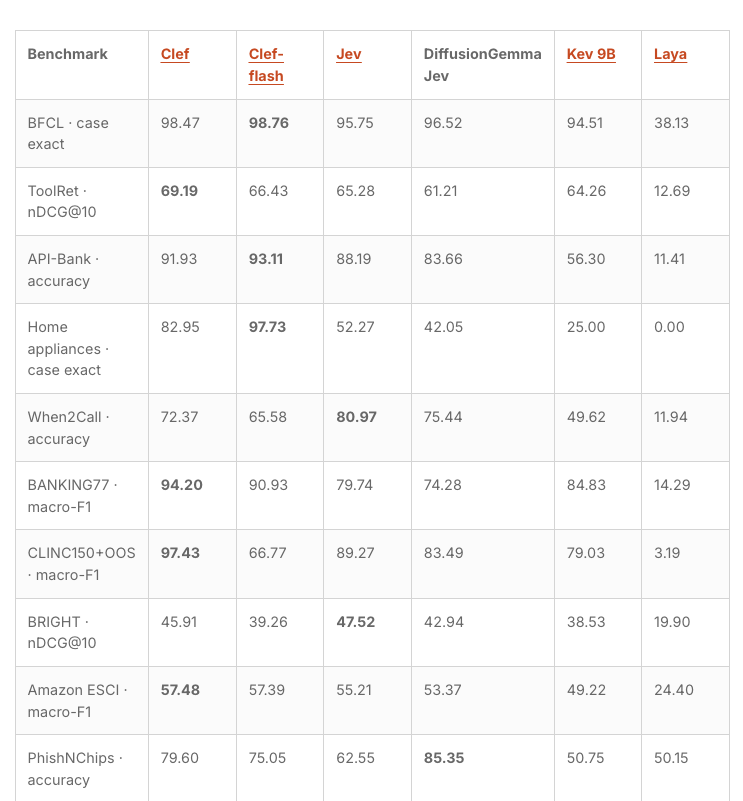
| 항목 | Clef | Clef-flash | Jev |
|---|---|---|---|
| BANKING77(은행 문의 분류) | 94.20 | 90.93 | 79.74 |
| CLINC150+OOS(의도 분류) | 97.43 | 66.77 | 89.27 |
| BFCL(함수 호출) | 98.47 | 98.76 | 95.75 |
| When2Call(도구 호출 시점) | 72.37 | 65.58 | 80.97 |
| BRIGHT(검색 순위) | 45.91 | 39.26 | 47.52 |
| 중간 지연 | 209.3ms | 38.8ms | 524.1ms |
눈에 띄는 건 두 가지입니다. 하나는 Clef-flash가 의도 분류(CLINC150+OOS) 평가에서 66.77로 다른 모델보다 크게 낮았다는 점입니다. 속도만 보고 고르면 안 되는 이유입니다. 다른 하나는 "도구를 지금 불러야 하나"를 가리는 When2Call에서 Jev가 8점 넘게 앞섰다는 점입니다. 에이전트의 다음 행동을 고르는 용도라면 바로 갈아타기보다 비교부터 해 볼 이유가 됩니다.
Cloudflare가 Typesafe의 업무형 평가 모음 4종으로 잰 결과에서도 Clef는 청구서 처리·고객 응대·보안 사고 3개에서 Jev보다 높았고, 에이전트 기록 관찰에서는 Jev(71.6)가 가장 높았습니다. 오픈 가중치 판정 모델끼리의 비교가 궁금하면 Jev 없이 판정 AI 돌리기 글에 정리한 Laya 이야기도 함께 보세요. 이번 표에서 Laya는 중간 지연 5.8ms로 가장 빨랐지만 점수는 크게 낮았습니다.
반응형
5. 파인튜닝과 오픈AI Decisions API
Cloudflare는 Clef를 내 업무에 맞춰 다시 학습시키는 강화학습(RL) 파인튜닝도 함께 발표했습니다. 다만 지금은 직접 버튼을 눌러 쓰는 기능이 아닙니다. Cloudflare의 현장 엔지니어(FDE) 팀과 함께 진행하는 서비스이고, 데이터 수집부터 재배포까지 혼자 하는 셀프서비스 플랫폼은 그다음 단계로 예고만 됐습니다.
같은 주 오픈AI도 개발자 행사에서 Decisions API를 발표했습니다. 정해 둔 답 가운데 하나를 고르는 구조라 목적은 비슷합니다. 하지만 아직 제한 프리뷰이고, 이 글을 쓰는 10월 2일 기준으로 가격과 정식 문서는 찾지 못했습니다.
| 비교 | Clef(Cloudflare) | Decisions API(오픈AI) |
|---|---|---|
| 상태 | Workers AI에서 바로 호출 | 제한 프리뷰 |
| 가격 | 입력 100만 토큰당 Clef 0.24달러, Clef-flash 0.09달러 | 발표문에서 확인 못 함 |
| 가중치 | 공개(Apache 2.0) | 비공개 |
| 내 서버 실행 | 가능(가중치 공개) | 발표문에서 확인 못 함 |
제 판단으로는 판정을 이미 Jev로 돌리고 있다면, 같은 질문 20~30건을 Clef-flash에도 보내 확률을 나란히 저장해 보는 것이 가장 싼 확인법입니다. 확률 값만 따로 저장해 두면 나중에 기준선을 바꿔도 다시 호출할 필요가 없습니다.
Q. Clef는 무료인가요?
가중치는 Apache 2.0으로 무료 공개됐습니다. Workers AI에서 호출하면 하루 10,000 Neurons까지 무료이고, 넘으면 Workers 유료 플랜에서 입력 100만 토큰당 Clef 0.24달러, Clef-flash 0.09달러가 붙습니다.
Q. Jev 코드를 그대로 쓸 수 있나요?
Cloudflare는 Jev와 API가 호환된다고 밝혔습니다. 요청 주소와 인증, model 값만 바꾸면 되지만, 같은 질문에 같은 확률이 나온다는 뜻은 아니니 결과를 비교해 보세요.
Q. Clef가 Jev보다 항상 정확한가요?
아닙니다. Cloudflare 자체 측정에서도 When2Call, BRIGHT, 에이전트 기록 관찰 평가에서는 Jev가 앞섰습니다.
Q. 한국어 문의도 판정하나요?
모델 문서는 언어 제한을 따로 적지 않았습니다. 다만 공개 벤치마크는 영어 위주라, 한국어로 쓸 계획이면 실제 문의 몇십 건으로 먼저 확인하는 게 안전합니다.
3줄 핵심 요약
- Clef(27B)·Clef-flash(9B)는 Cloudflare가 10월 1일 Apache 2.0으로 공개한 판정 모델로, 이미지 입력과 65,536토큰 문맥을 지원한다.
- Workers AI에서 입력 100만 토큰당 0.24·0.09달러, 하루 10,000 Neurons까지 무료다.
- 성적은 자체 발표이고 When2Call·BRIGHT는 Jev가 앞섰다. 바꾸기 전에 내 데이터로 비교하자.
마치며
판정 모델은 이제 Jev 하나만의 이야기가 아닙니다. 오늘 할 일은 하나면 충분합니다. 지금 쓰는 판정 질문 하나를 골라 Clef-flash에 무료 할당량으로 보내 보고, 기존 결과와 확률이 얼마나 다른지 표 한 장에 적어 보세요.
#Cloudflare,#Clef,#ClefFlash,#판정모델,#Jev,#WorkersAI,#오픈가중치,#DecisionsAPI,#AI에이전트,#코드노트
728x90
반응형
'서버·개발 > 코드 노트' 카테고리의 다른 글
| 깃허브에 올린 키, 아직 살아 있을 수 있다 | 작동하는 키 54만 개 조사로 본 내 저장소 점검법 (0) | 2026.10.02 |
|---|---|
| 클로드 코드 Mods 나왔다 | 플러그인·훅·스킬과 뭐가 다른가, 설치 전에 볼 권한 (0) | 2026.10.02 |
| 코딩 에이전트에게 권한을 얼마나 줄까 | 깃허브 코파일럿 로컬 샌드박스와 보조 승인 (0) | 2026.10.01 |
| 받은 저장소를 AI 에이전트로 열기 전에 | .git 설정 한 줄로 명령이 실행되는 GitSpawn (0) | 2026.10.01 |
| AI가 만든 테스트는 통과했는데 결과가 틀렸다 | 바이브 코딩 261편 중 6편 사례와 검증 3가지 (0) | 2026.09.30 |


댓글 영역